一个 Agent 做错了任务,我们让它反思一下,再试一次。如果第二次成功了,这算不算“自我改进”?如果它把经验存进记忆,下次遇到类似任务时直接避开错误,又算不算 RSI?如果它还能修改“如何分析失败、如何提出修复、如何选择下一次实验”的流程,区别又在哪里?
这些问题把 self-reflection、self-training、self-evolving agents、Agent Memory 和 Recursive Self-Improvement 串在了一起。但它们解决的问题并不完全相同。
这篇笔记选取 31 篇相关文献,整理成一张阅读地图:先分清概念,再看代表方法,最后讨论怎样判断改进是否真实、哪些问题适合继续研究。文末给出完整论文索引,方便回看。
阅读范围: RSI 指 Recursive Self-Improvement,即递归自我改进,重点讨论大模型与 Agent。资料核对截至 2026 年 10 月 29 日。正文区分论文报告、概念解释与选题建议。
这篇文章可以分几次读,不必一次记住全部论文。初次接触这个方向,可以先看第 1 节的例子,再到第 3 节理解反思、自训练和工作流,最后回到第 2 节读 RSI 主线。已经做过 Agent 的读者,可以重点看 DGM、元技能、评估者共同演化,以及第 5 节的实验判断。文末的 31 篇索引主要供查找,正文负责解释它们为什么值得放在一起。
1. 先分清:改好答案、改好系统、改进改进流程
我会先问三个问题,而不是看到论文标题里的 self 就把它们归为同一类。
第一层:这一次的输出有没有变好?
例如,模型先写答案,再生成批评,最后重写。任务结束后,模型参数、技能库和优化程序都没有变化。这主要是推理时修订。Self-Refine 是典型入口。
第二层:经验有没有变成持久的系统更新?
模型可以保留反思记忆、积累可执行技能,也可以用筛选后的生成数据继续训练。更新会影响后续任务,改进载体可能是权重,也可能是外部记忆、提示词或代码。Reflexion、STaR、Voyager 分别展示了不同载体。
第三层:负责产生改进的机制,是否也进入了优化范围?
假设我们最初固定了这样的流程:分析错误 → 提出修改 → 执行验证 → 保留候选。如果系统可以进一步调整错误分析方式、搜索策略、评估方法或预算分配,那么它开始触及“怎样更有效地产生下一次改进”。STOP 和 MetaSkill-Evolve 很适合从这里读起。
这三层是本文为了阅读方便采用的区分,不是整个领域统一认可的等级标准。不同论文使用 RSI 的范围不同:有的强调后代持续参与自修改,有的要求改进算子本身可变,还有的讨论模型训练过程的递归更新。
因此,比争论某篇论文“到底算不算 RSI”更有帮助的做法,是把递归边界明确写出来。
| 主要改变什么 | 典型载体 | 代表入口 |
|---|---|---|
| 当前答案 | 输出文本、当前推理轨迹 | Self-Refine |
| 后续任务的经验 | 文本记忆、上下文手册、技能库 | Reflexion、ACE、Voyager |
| 模型本身 | 权重、训练数据、偏好信号 | STaR、SPIN、Self-Rewarding |
| Agent 的执行方式 | 提示词、工具、控制流、工作流 | OPRO、AFlow、ADAS |
| 改进过程 | 改进器代码、元技能、搜索策略 | STOP、MetaSkill-Evolve、Skill∞ |
| 判断改进的方式 | 评估器、评分规则、评价任务 | RQGM、EvalResearchBench |
用同一个编程任务,把三个层次串起来
下面是为帮助理解而构造的例子。
假设一个编程 Agent 要修复日期解析函数。它第一次把空字符串处理错了,测试失败。我们可以设计四种后续行为:
| 后续行为 | 留下了什么变化 | 下一次任务能否直接受益? |
|---|---|---|
| 把测试错误放回当前对话,重新写补丁 | 当前补丁和当前任务上下文 | 不能仅凭这次成功判断;对话结束后可能没有保留 |
| 记录“日期解析应检查空输入、时区和非法格式” | 一条跨任务经验 | 可能,但要检查检索是否命中、经验是否适用 |
| 把检查步骤写成可执行的测试辅助工具 | 一个可复用技能或工具 | 可能,收益也可能来自更稳定的执行方式 |
| 发现原先的复盘流程总忽略边界测试,进而修改复盘与候选选择规则 | 产生后续改进的流程 | 更接近元层面的改进,仍需独立验证 |
四种行为都可能有用,区别在于哪个对象发生变化,变化会保留多久,以及它怎样影响下一轮任务。把第二种行为叫“记忆学习”,或把第四种行为放进 RSI 讨论,都是为了说明机制,不能代替实验结果。
还有一个很容易忽略的问题:如果系统把错误经验也保留下来,它同样会影响未来。持续更新只说明系统在变化,不能保证变化方向正确。成功经验的适用条件、失败经验的归因、旧技能的失效和撤销,都是这条路线的一部分。
冻结模型,为什么整个 Agent 仍然可能变强?
可以把模型看作一套基础能力,把 Agent 看作围绕这些能力组织起来的执行系统。相同模型,在不同的上下文、工具接口和控制流程下,可能做出不同的动作。
例如,文件编辑工具从“整段重写”变成“定位后局部替换”,不会改变模型权重,却可能减少误改;上下文从完整日志变成有来源的错误摘要,也可能帮助模型找到真正的失败原因。这里变化的是系统如何使用模型,而不是模型参数本身。
这也是阅读时最好同时画出两个边界的原因:模型的边界和可修改系统的边界。一篇论文可以在冻结模型的情况下研究系统层自修改;它能支持怎样的 RSI 主张,则取决于可修改范围、递归使用方式与评价证据。
2. RSI 的核心论文,可以沿着这条线读
2.1 Gödel Machine:先给自修改一个理论形式
Gödel Machines 考虑一种能够修改自身代码的系统:当它找到证明,说明某次修改有利于既定效用时,就执行修改;证明搜索器本身也属于可修改代码。
这里最重要的思想是自指:改进机制不必永远置身于系统之外。但其理论性质依赖公理、效用函数和可证明性条件,不能把它直接当作现实 LLM 的性能保证。
从研究思路看,Gödel Machine 把问题设得很强:不只寻找一个新策略,还要考虑“执行这次改写,是否优于继续搜索其他改写”。因此,它讨论的是带条件的理论性质,而不是“让模型读自己的代码就会变聪明”这一条经验规则。
后面的实证论文通常会放宽这一要求,用测试、环境反馈和统计比较判断改动。这让系统更容易实际运行,但也意味着我们要重新面对测试不完整、反馈有噪声和评价过拟合等问题。读理论源头的价值,是看清后来方法替换了哪一种保证。
2.2 STOP 与 Gödel Agent:把改进过程变成可执行代码
STOP 从一个调用语言模型优化程序的 improver 出发,再让它优化自己的代码。它把“优化器也可以是优化对象”这件事表达得很直接。作者同时明确指出:语言模型本身没有改变,因此这不是 full RSI。
Gödel Agent 则研究 Agent 在运行过程中读取并修改自身逻辑。它提供了代码层自修改的实践入口,但不继承 Gödel Machine 的形式化最优保证。
读这两篇时,可以画出两条线:一条是被修改的任务程序,另一条是产生修改的改进器。检查第二条线有没有变化,往往比看调用了多少次模型更有信息量。
可以用一段概念性伪代码理解 STOP 的问题。它用于解释改进器与任务程序的关系,不是原论文实现:
普通程序优化:
    改进器 I 接收任务程序 P
    I 生成候选程序,并用任务评价选择结果

改进器优化:
    把 I 自身的实现也作为待修改程序
    比较候选 I 在一组任务上产生改进的效果
    保留有用的候选,再让后续优化使用它
这里最难的环节其实是第二次评价:判断一个补丁是否通过测试,与判断一个改进器是否善于产生好补丁,不是同一个问题。后者通常需要多项任务、多次尝试与明确预算。
Gödel Agent 则让我们注意运行时状态:程序修改后,哪些逻辑会在后续执行中真正生效?改变文件中的一段说明、替换一个函数、调整工具选择规则,三者的作用范围不同。研究自修改系统时,既要查看修改文本,也要检查实际执行轨迹和继承关系。
2.3 DGM:从单条修改链,走向多个 Agent 的档案
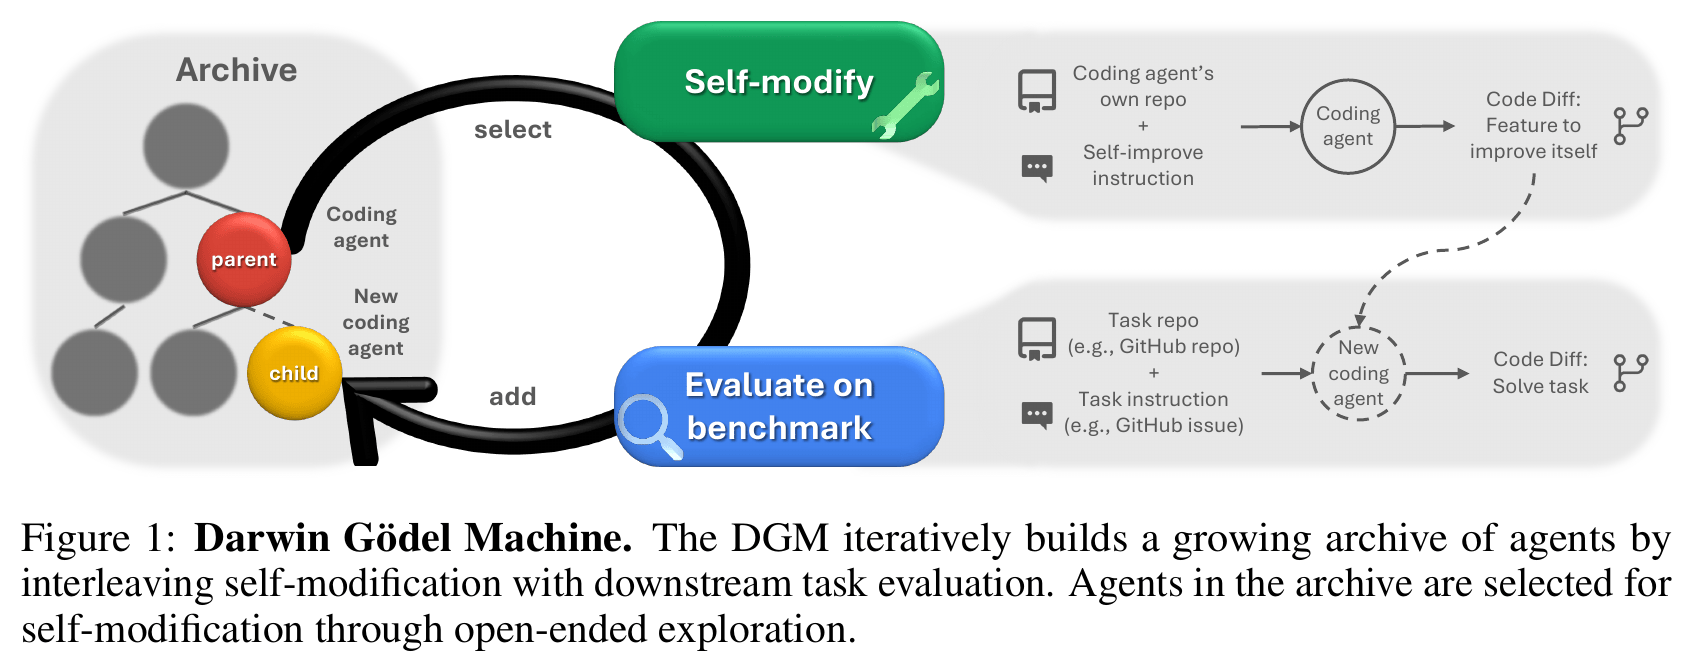
来源:DGM v3 PDF 第 2 页,Figure 1。截图保留完整流程和原图注。先看左侧档案,再看右上角修改自身代码与右下角解决任务的区别。
Darwin Gödel Machine 维护一个 Agent 档案,从已有版本中选出父代,生成修改后的子代,并用编程任务评估。后代也可以继续参与自修改,因此搜索形成一棵树,允许保留不同路线。
它的重点是通过实际评估选择改动,而不是证明改动一定有益。需要同时记住:底座模型冻结;可修改的是 coding-agent 代码,档案维护和父代选择等开放式搜索外循环仍固定。这是一种有边界的系统演化,不代表整个系统的所有改进机制都已经可自改。
档案的意义可以用一个搜索例子理解:某个版本的当前得分不高,却引入了更清楚的工具接口;另一个版本在它的基础上修复调用流程,才出现较大的收益。如果只保留眼下最高分的一个版本,这条路线可能被过早舍弃。这是理解“中间踏脚石”的直觉,并不表示任意低分版本都值得保留。
下面这张结果图可以与前面的结构图对照着读:
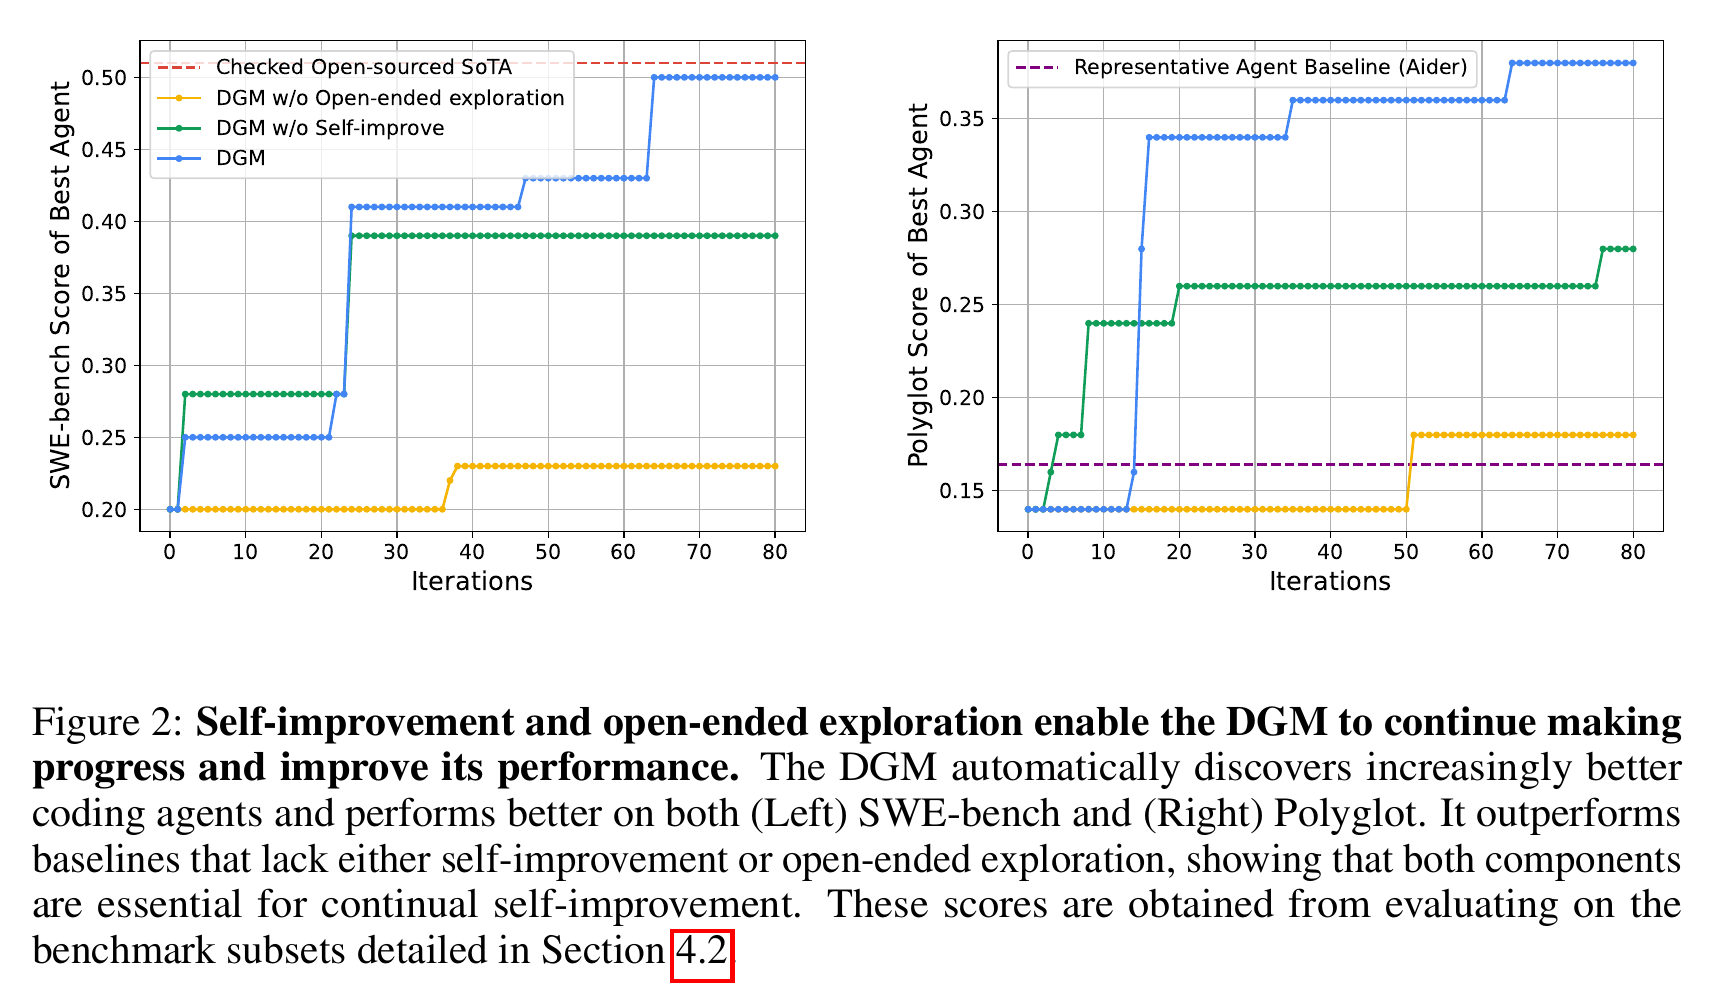
来源:DGM v3 PDF 第 7 页,Figure 2。图中得分来自论文 §4.2 说明的基准子集,横轴是搜索迭代,不是梯度训练轮数。
论文设置了两组重要对照:固定负责修改的基础 Agent,观察不让改进者随代际变化时会怎样;移除开放式档案,始终从最新仍具备代码编辑能力的版本继续自修改。它们分别帮助检查自修改与搜索结构的贡献。
读曲线时还要注意,纵轴是“截至当前找到的最佳 Agent”。保留历史最佳值,本来就会使这条记录不下降;它不说明每个新版本都更好,也不说明收益会永远加速。要进一步理解进步的来源,还应看被固定的组件、任务子集、评估预算与独立复测。实验设置与对照
这组消融支持自修改与档案探索对任务成绩的贡献,但没有单独测出后代作为改进器的能力是否更强。第 2.6 节的 AIDE² 正好提供了怎样进一步追问的例子。
2.4 MetaSkill-Evolve 与 Skill∞:把“怎样改技能”也写成技能
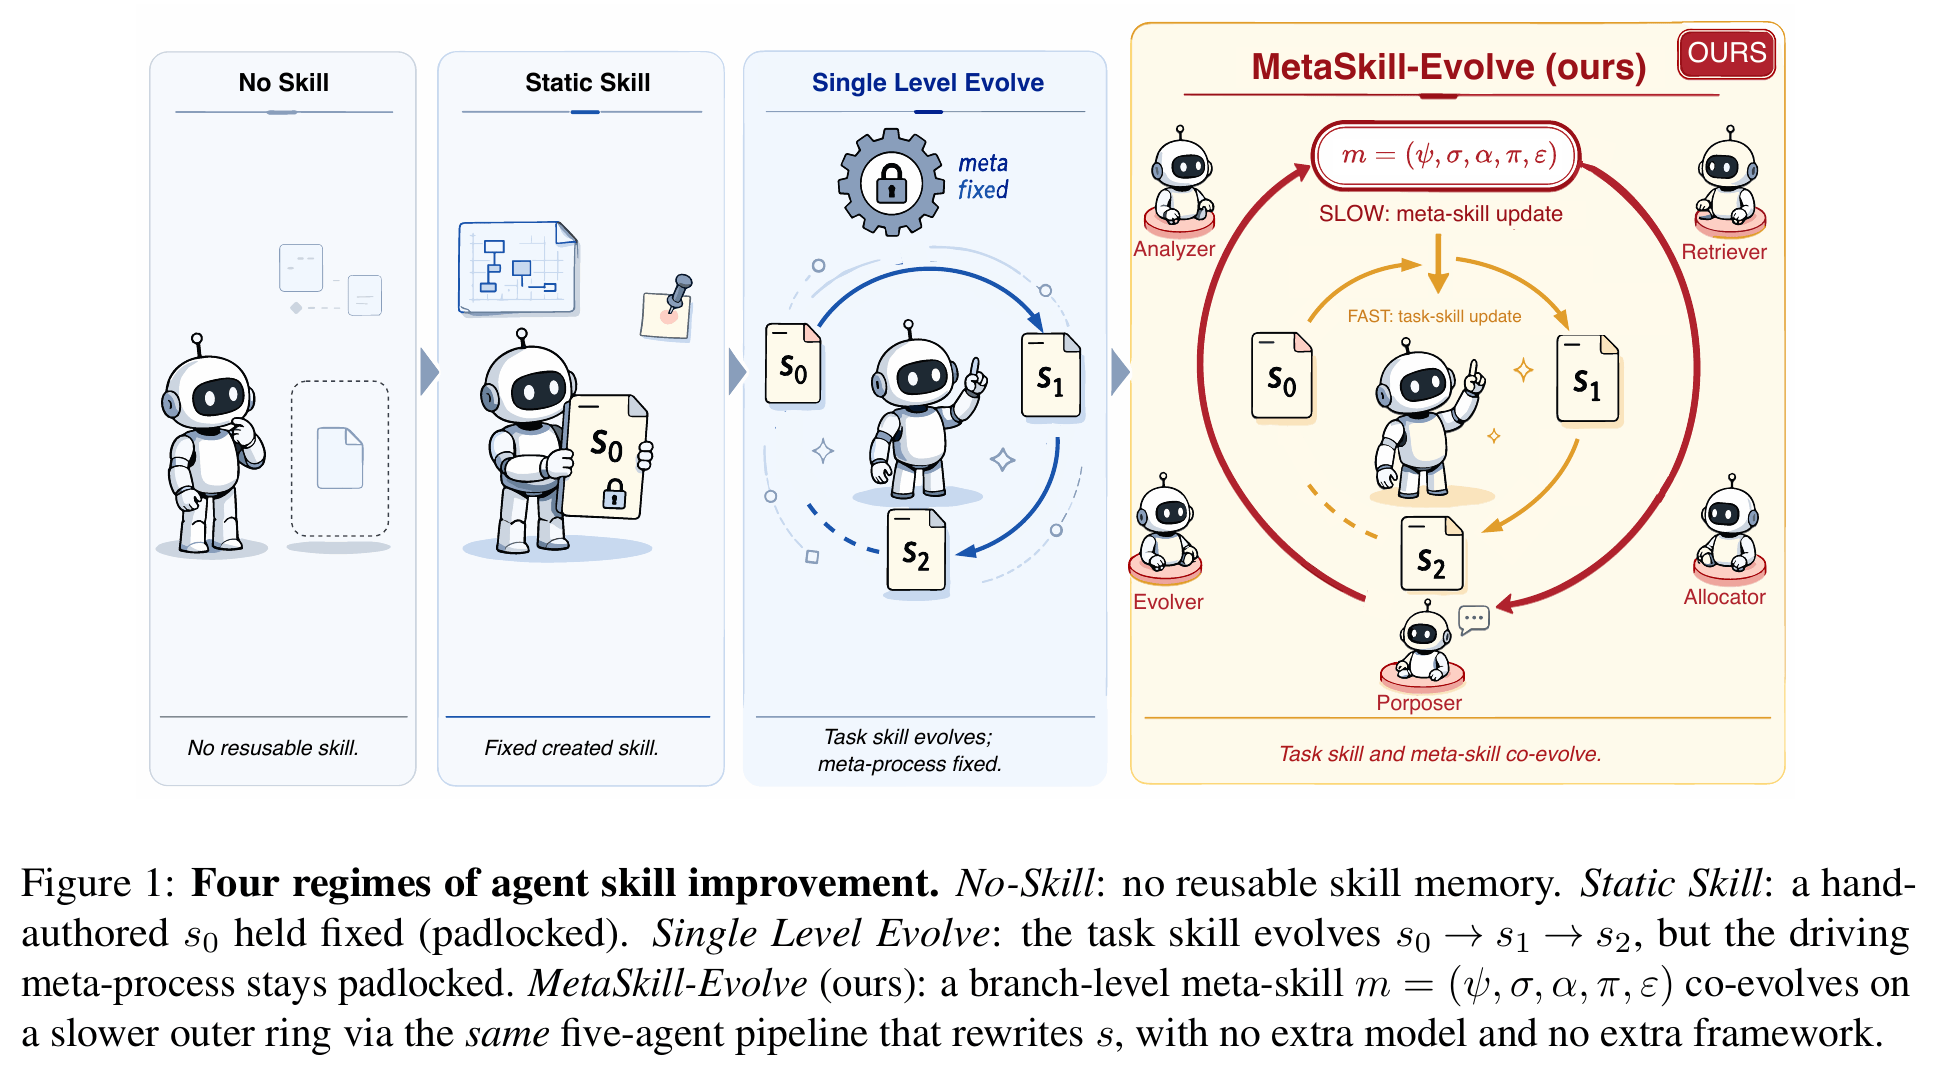
来源:MetaSkill-Evolve v1 PDF 第 2 页,Figure 1。第三栏的任务技能在变,但元流程固定;最右栏进一步让元技能参与演化。
MetaSkill-Evolve 区分任务技能与元技能:前者规定怎样做任务,后者影响诊断、检索、预算分配和修改建议等环节。任务技能在快循环中变化,元技能在较慢的循环中变化,底座保持冻结。
Skill∞ 同样把技能优化过程表示为 meta-skill,并关注把优化后的元技能复用于不同任务。它于 2026 年 10 月 26 日公开预印本;阅读时还要看自动验证器的可靠性,以及 Agent 是否确实遵循元技能,而不只是生成了看起来合理的说明。
这条路线对工程实现很有启发:不更新模型权重,也可以研究持久改进。但实验必须区分两种收益——技能内容变好了,还是产生技能改进的过程变好了。
任务技能与元技能的区别,可以继续用日期解析的例子来理解:前者可能写着“怎样测试日期输入”,后者则规定“怎样从一次失败中判断应该改测试、改工具还是改步骤”。一个作用于任务执行,一个作用于任务技能的修改。
MetaSkill-Evolve 的五类改进角色,恰好可以帮助拆开这个过程:
| 环节 | 教学上的理解 | 如果做得不好,会产生什么问题? |
|---|---|---|
| Analyzer | 解释执行记录中的失败与机会 | 归因错误,把工具故障当成推理错误 |
| Retriever | 查找与当前修改相关的经验或分支 | 找到相似词句,却带来不适用的经验 |
| Allocator | 分配候选、分支与尝试预算 | 在无效方向上投入过多资源 |
| Proposer | 把诊断转成可执行的修改建议 | 建议抽象,无法明确实施和验证 |
| Evolver | 应用修改并检查结果 | 文本改了,实际流程却没有使用它 |
表中的失败例子是帮助理解的分析,不是论文逐条报告的实验。快慢两个时间尺度也提供一种直觉:任务技能可以频繁试改,而调整改进规则最好观察一段时期内的后代,避免让一次偶然成功决定整个搜索方向。
这里也有固定边界:五个角色及连接方式、更新周期和共享骨干不是任意演化的对象。论文通过完整系统与单层基线、分组件消融讨论收益;阅读时应逐项核对基线同时关闭了哪些功能,不宜把完整系统的所有差值都归因于一次元技能更新。
Skill∞ 进一步强调元技能跨任务复用。这带来一个需要单独检验的问题:它学到的是通用的诊断、验证和预算管理方法,还是某类任务的特殊技巧?因此,跨任务留出、相同底座和相同预算的对照,比单看训练任务上的最终得分更关键。名字里的无穷符号,也不能当作已经证明无限改进的含义。
2.5 RQGM:如果评估者也需要进步怎么办?
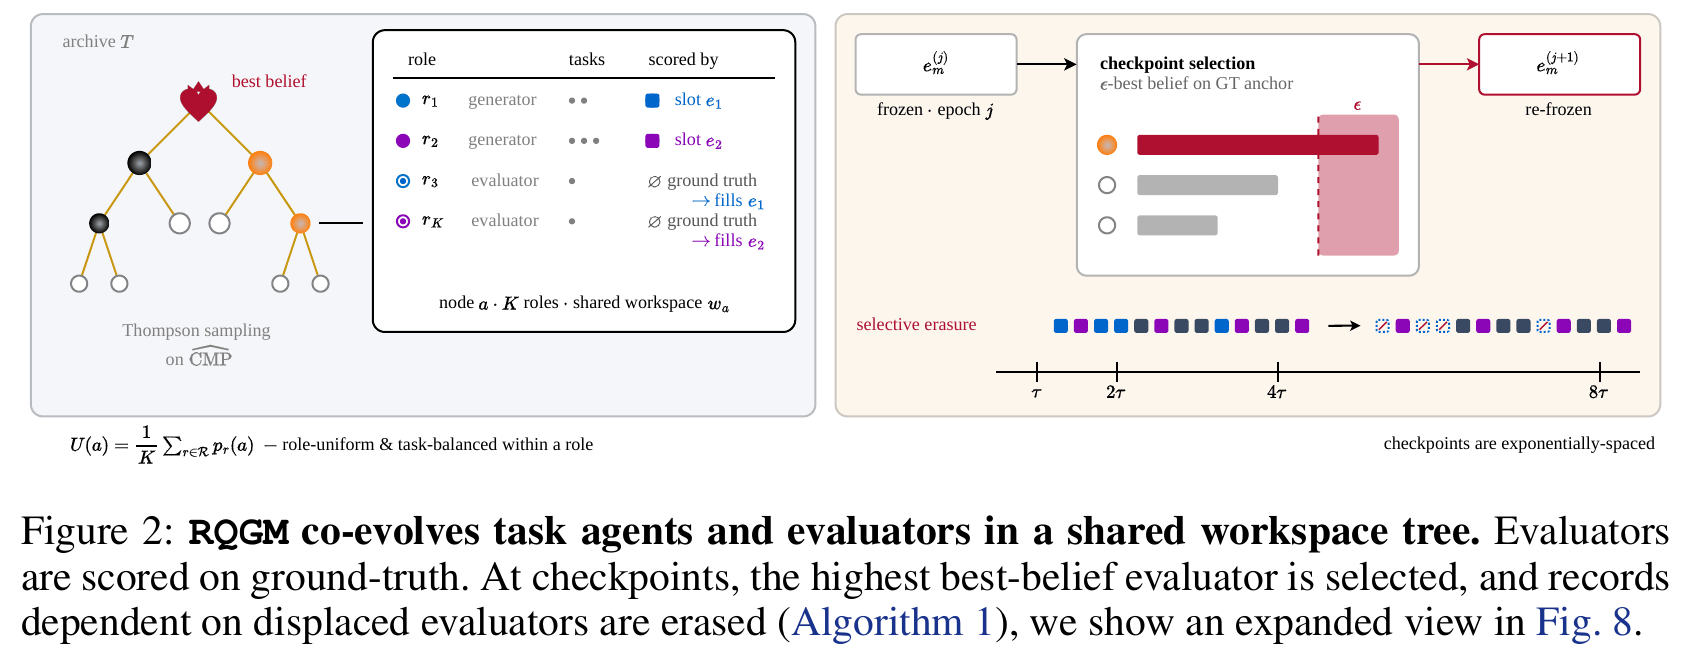
来源:RQGM v3 PDF 第 3 页,Figure 2。左侧是共享工作空间的搜索树,右侧展示评估者替换与相关记录处理;图注强调评估者仍以 ground truth 评分。
固定测试集或固定 judge 可能成为瓶颈:系统逐渐擅长的是拿高分,未必是我们真正关心的能力。RQGM 将任务 Agent 与学习型评估者一起纳入演化,同时用独立的真实评价锚点约束评估者。
它把一个重要问题放到了台前:评价者变了之后,不同轮次的分数还能不能比较? 评估者共同演化需要外部校准,而不只是让两个模型彼此认可。该工作仍标注为进行中的预印本。
例如,同一个补丁在旧评价者那里得 6 分,在新评价者那里得 9 分。系统至少要区分两种解释:补丁真的更好,或者新评价者更宽松。只看一列不断变高的分数,无法判断是哪一种。
RQGM 的关键结构包括用独立 ground-truth 锚点评估学习型评价者,以及在评价者替换后处理依赖旧评价者的记录。它并不是把所有评价规则都交给系统随意重写;固定评分与编排框架仍提供边界。这个例子把“评价本身是研究对象”和“评价仍需要可比较的依据”连接了起来。
2.6 AIDE²:任务能力提高,不等于改进能力已提高
AIDE² 优化研究 Agent 自身的代码,并评估改动对 AI 研究任务的帮助。其主实验外层改进器是固定的 AIDE_human,内外圈的基础模型也固定。
论文还区分了用于任务搜索的反馈、用于外层版本选择的 private grade,以及不参与这些选择的独立任务评估。这里的 private 不能直接翻译成“完全没被用于优化的最终测试”:只要外层反复依据它选版本,它就是选择过程的一部分。这一点也适用于我们自己的实验。
论文另外设置 ignition test:把发现的 Agent 放到外层,检查它能否更有效地驱动下一轮改进。每组仅三个随机种子,作者明确认为结果尚不确定,不能证明新 Agent 比原改进器更强。方法与 §3.6
这是我认为很值得保留的实验思路:单独测量“产生改进的能力”,而不只测量被改进系统的任务分数。
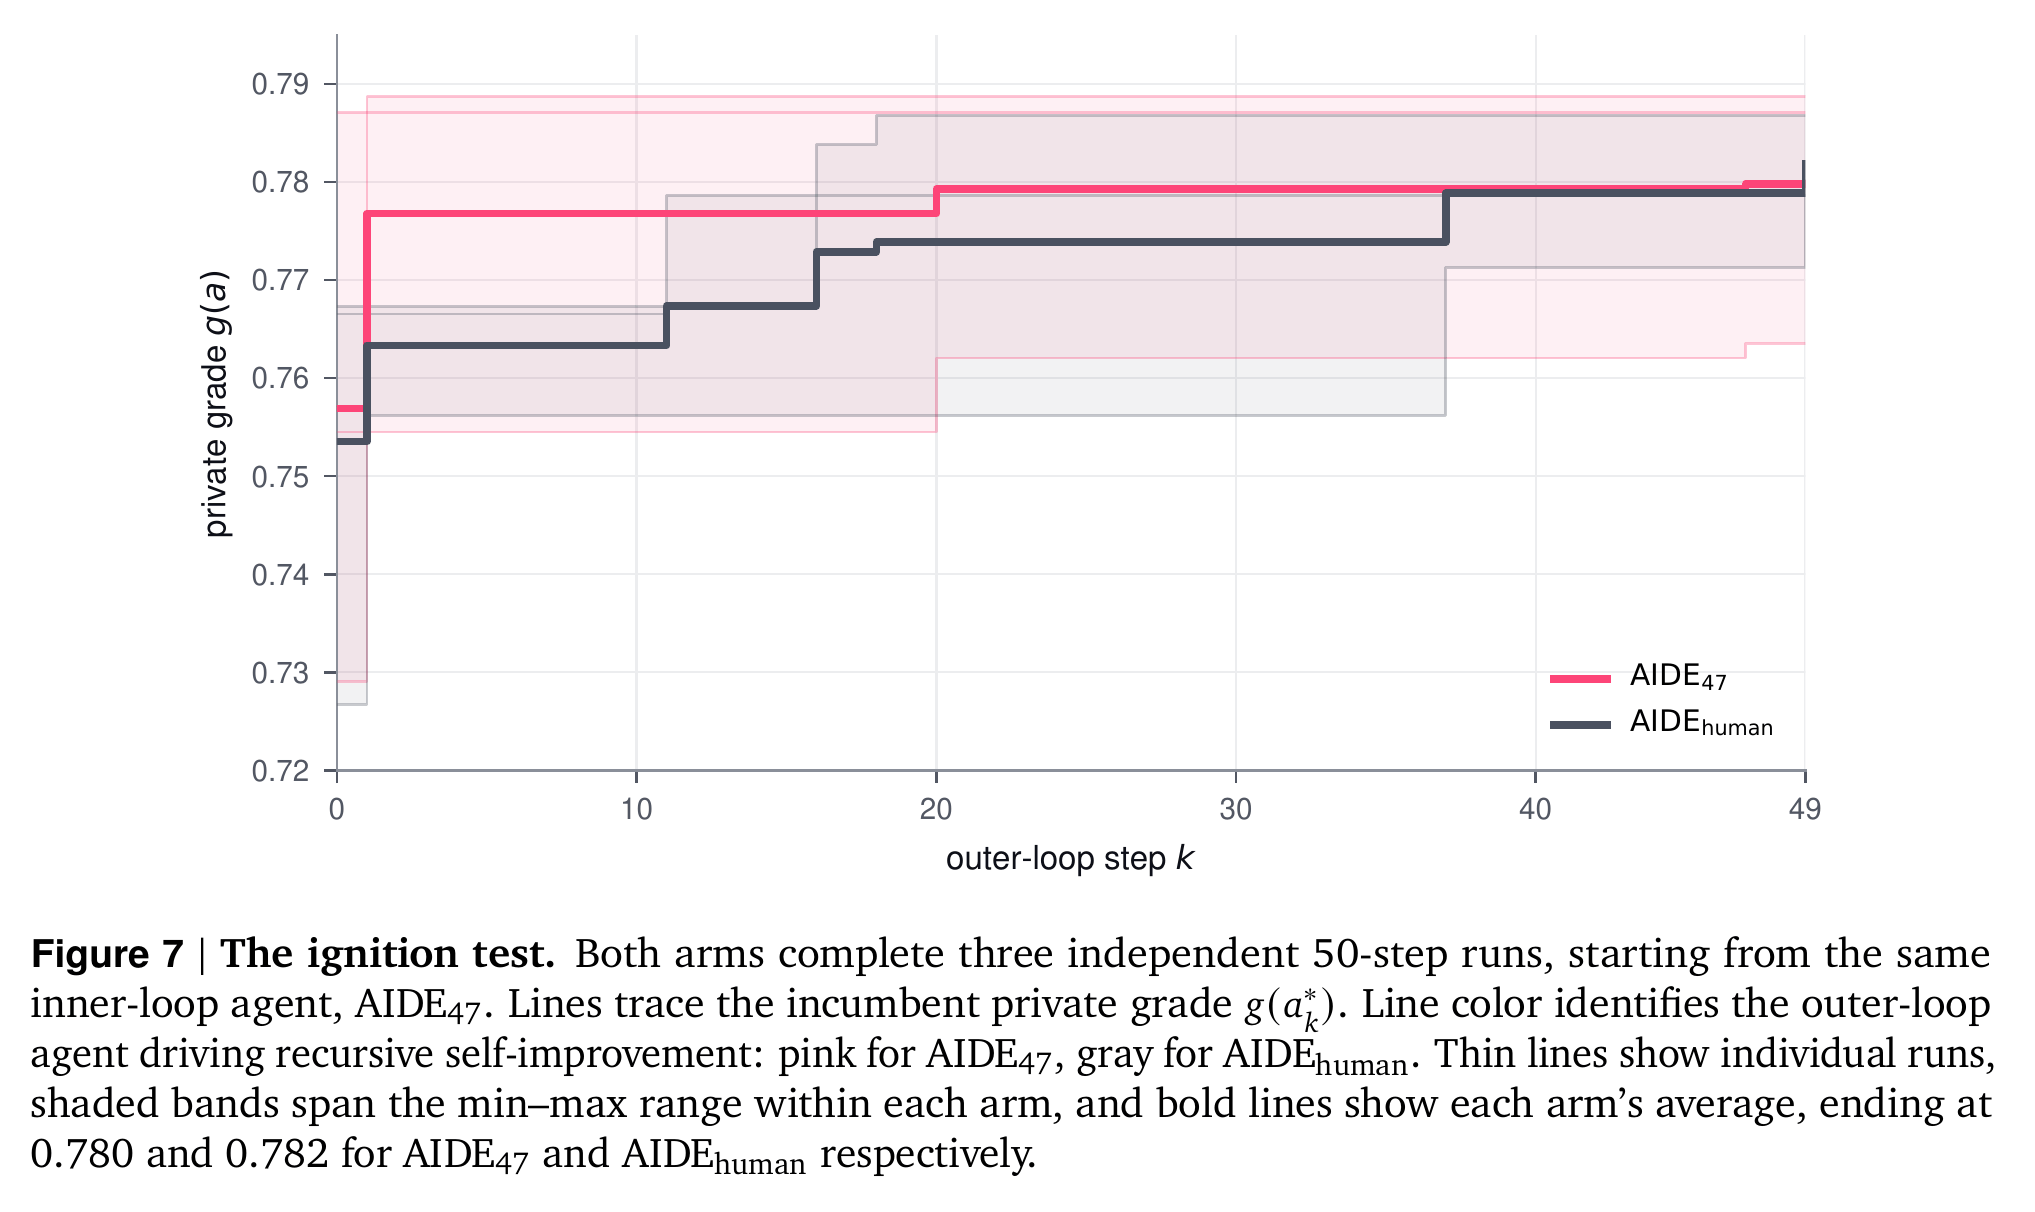
来源:AIDE² v1 PDF 第 11 页,Figure 7。两组从相同的内层 Agent 开始,分别由发现的 Agent 与人工设计的 Agent 驱动外层改进。
这张图可以按三个问题来读。第一,起点是否相同?相同起点有助于隔离外层改进器的差异。第二,图中的粗线、细线和阴影分别是什么?它们表示组内平均、单次运行和最小到最大范围;阴影不是自动等同于某个置信区间。第三,作者是否声称发现了更强的改进器?原文明确没有作出这一结论。
有时一条平均曲线看起来更早上升,会让人直觉上觉得“改进更快了”。但有限随机种子下,这还可能受到任务、候选和执行随机性的影响。AIDE² 的价值之一,是把这个诱人的解释变成一个单独的实验问题,并报告证据尚不足的部分。
3. 相邻概念:它们怎样接到 RSI 上?
3.1 自我修订、自我反思、记忆与上下文演化
| 论文 | 机制抓手 | 回忆时要分清的地方 |
|---|---|---|
| Self-Refine | 生成 → 自反馈 → 修订 | 主要改善当前输出,不要求训练。 |
| Reflexion | 将反馈转成文字反思,供后续尝试使用 | 文本记忆更新不等于梯度式强化学习。 |
| Voyager | 在 Minecraft 中自动探索并积累可执行技能 | 底层模型不因此被微调;增长的是技能库等系统组件。 |
| ACE | 将上下文作为持续更新的 playbook | 需要管理经验保留、去重与压缩,不是无限追加历史。 |
Self-Refine 与 Reflexion:反馈放在哪里,影响多久?
Self-Refine 的基本循环是“先生成一个版本 → 针对它给出具体反馈 → 根据反馈修订”。同一个模型可以承担生成、批评和修订,不必为这几个角色分别训练模型。它也会在当前任务的提示中保留之前的输出和反馈,因此不能简单说它“没有记忆”;更准确的说法是,这个机制本身不要求建立跨独立任务的长期经验库。
Reflexion 把重心放在试错之后留下什么。执行者产生轨迹,评价信号指出结果好坏,再把这次尝试整理成语言反思,存入有界的情节记忆,供下一次尝试使用。反馈可以来自环境、标量奖励或语言信息。论文标题中的 verbal reinforcement learning 描述的是语言反馈与记忆的作用;原方法通过语言反思与情节记忆更新行为,不更新模型权重。
举一个教学例子:生成月度统计 SQL 时漏掉了月末数据。Self-Refine 可以在当前任务里根据反馈修正 SQL;Reflexion 式的系统还可能保存“时间区间用左闭右开表示,并测试边界”的经验,让后续尝试查阅。二者可以组合:先在任务内修订,再决定哪些经验值得跨任务留下。关键不是选一个名字,而是检查反馈是否正确、记忆是否被使用、下一次任务是否真的受益。
Voyager 与 ACE:可执行技能,与可阅读经验
Voyager 在 Minecraft 中把自动课程、执行反馈和技能库连接起来。它会提出探索目标,生成并运行代码,根据环境结果和错误信息改写;成功的代码可以进入技能库,再通过技能描述检索、组合。这里留下的不只是“下次应该怎样做”的一句提醒,还有可以再次执行的程序。
ACE 则把上下文当作需要维护的工作手册。下面这张图展示了执行、复盘与整理的分工:
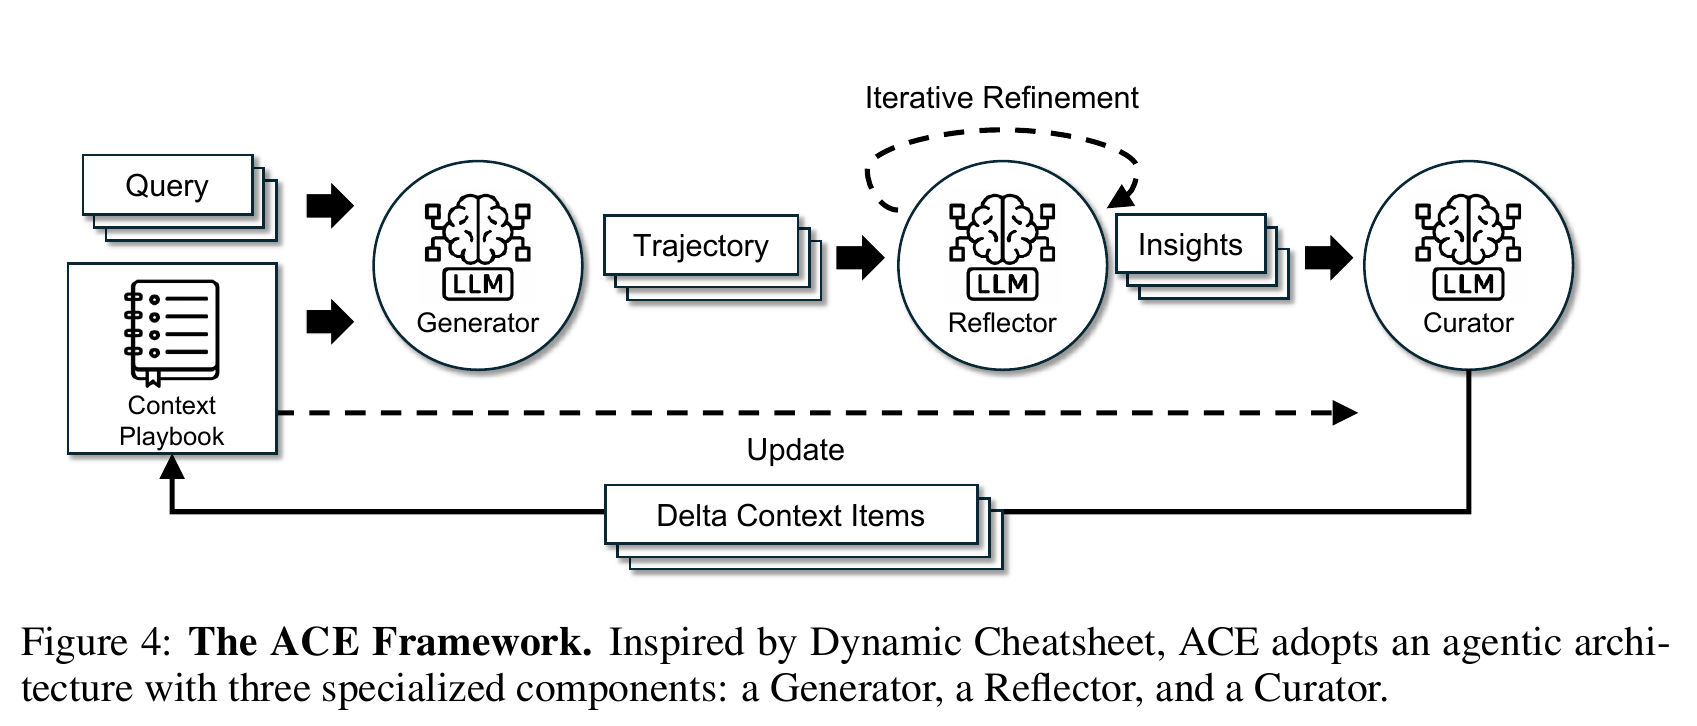
来源:ACE v3 PDF 第 5 页,Figure 4。Generator 产出轨迹,Reflector 提炼经验,Curator 整理为增量条目,再更新上下文。
ACE 特别适合作为记忆路线的入口:它把经验组织成可定位的条目,采用增量更新,减少整段重写带来的细节丢失。不过,上下文演化与模型权重学习是不同机制;一个不断增长的经验库,也不能单凭体积证明持续改进。
可以把它们放在同一个工程例子里理解:一次 API 请求漏抓了后续分页。经验手册里可以增加“有下一页游标时继续请求,直到游标为空”的带条件规则;技能库里则可以增加经过验证的 fetchAllPages()。前者方便模型理解和选择,后者把重复步骤交给程序执行。这个例子是为了比较载体,不是说两篇论文研究了这个 API 场景。
这条路线真正难的往往是经验治理:同一条规则在新版本 API 上还成立吗?两条经验冲突时信哪一条?检索不到有用条目,与检索出错误条目,分别会造成什么后果?上下文更长、技能更多,都只是中间状态;能在新任务中找到适用经验,并在失效时修订它,才接近可靠的长期收益。
3.2 自训练、自我奖励与自博弈
| 论文 | 主要改变什么 | 外部条件与边界 |
|---|---|---|
| STaR | 生成推理、筛选后训练,再重复 | 依赖给定问题和正确答案进行筛选。 |
| Self-Rewarding Language Models | 模型提供评价信号,进行迭代偏好训练 | 要检验评价能力,而不只检验回答分数。 |
| SPIN | 用历史模型生成的回答构造迭代训练 | 仍依赖原有人类示范。 |
| Absolute Zero | 出题、解题与可验证奖励组成自博弈 | zero data 指相应后训练阶段,不是没有预训练数据;执行器仍是关键结构。 |
这些方法把上一代系统的产出变成下一代的学习资源,构成重要的迭代改进路线。是否采用更严格意义的 RSI 描述,还要看其学习流程、任务生成器或评价机制是否也成为改进对象。
STaR:先生成推理,再用答案筛选
STaR 的出发点很直观:高质量推理过程昂贵,能不能让模型先生成一批,再拿其中有用的部分训练自己?它给模型少量推理示例,对带有正确答案的问题生成推理;回答正确的样本进入训练集。对于答错的问题,还可以把正确答案提供给模型,让它尝试反推出能到达该答案的推理,再筛选训练,重复这个过程。
因此,STaR 并不是“只靠模型随便想就获得了可靠监督”。问题与正确答案提供了重要的外部锚点。它说明生成内容可以成为学习材料,但仍需问:答案对了,推理过程是否也对?只按最终答案筛选,不能逻辑上保证每一步解释都可靠。这是读自训练论文时需要额外留意的证据边界。
SPIN:用上一代回答构造新的训练对手
SPIN 保留已有的人类示范答案,让当前模型为相同提示生成回答,再训练下一代模型,目标是使其相对于上一代更接近示范分布。更新后的模型又成为下一轮的对手。这里的“自博弈”不一定是两个游戏角色互相竞争,也可以是当前模型与历史模型之间构成训练关系。
它和 STaR 的相似点,是把模型产出用于下一轮训练;区别在于如何构造学习信号。STaR 更突出推理生成与正确性筛选,SPIN 则利用示范答案和上一代输出之间的对照。SPIN 不需要每轮再收集一批新的人类标注,但这不意味着整个过程从未使用人类数据。
Self-Rewarding:模型不仅回答,还参与打分
Self-Rewarding 把评价能力也放入迭代过程:模型生成候选回答,使用 LLM-as-a-judge 方式给出评分,再构造偏好对,进行迭代偏好训练。它从指令与评价示例等初始资源出发,并不是无条件地假设“回答能力强,所以评价能力一定强”。
这类方法值得同时画两条曲线:回答质量怎样变化,评分器对质量差异的辨别能力怎样变化。假如评分器总给相同分数,偏好对就缺少区分度;假如它偏爱篇幅和语气,训练可能强化这些表面特征。这里列举的是可能的失效方式,具体发生与否需要评分校准、人工或可执行标准等独立检查。
Absolute Zero:让出题与解题形成可验证循环
Absolute Zero 的关键不只是“自己出题”,而是把出题、求解和代码执行连起来。同一模型承担 proposer 与 solver:提出程序相关任务,再尝试求解,由执行过程检验有效性并提供学习信号。
出题奖励用当前 solver 的多次采样成功率近似衡量可学习性:成功率为零时奖励为零,否则为 1 − 成功率。它鼓励当前模型偶尔能解出的困难任务;这不等于直接测量训练后的收益,也不是精确追求 50% 成功率。奖励设计 §3.1
“Zero Data”针对相应后训练阶段没有外部任务数据,并不表示没有预训练,也不表示没有人为设计的任务结构、执行器与奖励。它帮助回答的是:在一个可验证的任务空间中,能否由系统持续生成训练材料?任务空间能否迁移到缺少可靠验证器的开放研究,是另一个需要单独研究的问题。
把这四篇放在一起,可以始终追问一句话:生成、筛选、评价与训练之中,哪一步提供了新信息,哪一步只是放大已有判断? 这比单独记住“模型训练自己”更有解释力。
3.3 提示词优化、工作流搜索与自动 Agent 设计
| 论文 | 优化对象 | 与 RSI 的连接 |
|---|---|---|
| OPRO | 利用历史候选与得分继续提出候选,典型应用是提示词 | 自动搜索,但搜索流程通常固定。 |
| TextGrad | 沿系统计算关系传播自然语言反馈,修改文本或代码变量 | 是复合系统优化工具,不代表普通数值微分,也不自动改进自身。 |
| AFlow | 通过代码表示、执行反馈与搜索生成工作流 | 需要区分工作流变化与工作流优化器变化。 |
| ADAS | Meta Agent 根据设计档案编写和评估新 Agent | 自动 Agent 设计与改进器递归更新有交集,但并不相同。 |
这里常出现 harness 或 scaffolding。可以先把它理解为模型外面的执行框架:怎样构造上下文、调用工具、组织控制流、处理错误和评估结果。优化这一层,可能在底座不变时明显改变系统行为。
OPRO 与 TextGrad:怎样把反馈变成修改?
OPRO 会把优化目标、历史候选和它们的得分提供给语言模型,再让模型提出新候选。用于提示词优化时,候选就是不同的提示词;它们在评价数据上得到分数后,继续成为下一轮搜索的参考。这是一种用语言模型提出搜索方向的方法,不需要把提示词变成可求导的连续向量,但仍需要评价资源。
TextGrad 面对的是另一种困难:一个系统有多个相互依赖的环节,最终结果不好,应该改哪里?它通过计算关系把语言反馈向前面的变量传播,用文字说明可能的修改方向,再更新提示、代码等变量。“梯度”在这里是对反馈传递与优化接口的类比,不能当作普通数值导数,也不自动带来收敛保证。
例如,一个“检索 → 总结”的系统漏掉关键事实。整体提示词搜索可以尝试新的候选组合;沿依赖关系传播反馈,则可能分别指出“检索查询太窄”与“总结遗漏了已有证据”。这个教学例子也揭示了难点:如果反馈把错误归到不该负责的环节,就可能越改越偏。因此,局部改动后的实际复测仍然必要。
AFlow 与 ADAS:从改一句提示,到改整个执行结构
AFlow 用代码表示工作流,在给定算子和搜索框架内,选择已有工作流、提出修改、执行验证,再把反馈带回搜索。ADAS 的 Meta Agent Search 则让元 Agent 参考已有设计及成绩档案,提出新 Agent 实现,经过检查、调试与评价,再纳入档案。二者的搜索空间和组织方式有差异,但都把系统结构变成可自动探索的对象。
举例来说,“独立生成三个答案再投票”是一种工作流;“让专门角色检索证据、交叉检查、整合分歧”则涉及角色和通信设计。这些空间可以重叠。阅读时应检查代码里究竟允许改节点提示、连线、调用次数,还是工具和控制逻辑,而不只依赖 workflow 或 agent design 的名称。
这一组工作与 RSI 的连接点在于:它们提供了有用的改进对象和搜索方法。进一步的问题是,负责搜索的程序是否也会被修改?如果流程一直由同一个外部搜索器运行,它仍然可以非常有效,但“系统设计自动化”与“改进器能力提高”需要分开报告。另外,最终得分也要连同模型调用数、执行时间与搜索成本一起看。
3.4 开放式演化、自动课程、元学习与 AI for AI
POET:任务也需要演化
POET 让环境与求解策略成对演化:从已有环境产生变体,筛选有新意且难度适中的环境,在各环境中优化策略,并尝试把其他环境里学到的策略迁移过来。它的重要直觉是,当前最难任务未必是最有帮助的下一步;一个不同方向的挑战,也可能为原来的困难提供踏脚石。
因此,自动课程不只是把难度不断调高,还涉及多样性、可学习性与迁移。原论文以二维双足运动环境为实验载体,环境表示、变异方式、奖励和准入机制都有边界。标题中的 endlessly 传达开放探索的目标,不能当作已经证明在任意领域无限进步。
MAML:“更容易学习”也可以是目标
MAML 学习的是一种适合快速适应任务的参数初始化。内循环在某个任务上做少量梯度更新;外循环再根据适应后的效果,更新共同的初始化。它连接了我们关心的一个问题:当前状态的价值,不只在于现在能得多少分,还在于它能否更有效地适应接下来的任务。
但 MAML 依赖给定的任务分布、损失和更新形式,不能把“学会学习”的概括理解成自动发明整个学习算法。它适合帮助理解元目标与内外循环,而不是直接作为 LLM 递归自修改已经成立的证据。
AlphaEvolve 与 AI for AI:让研究成果回到计算系统
AlphaEvolve 展示 LLM 驱动的程序演化:从程序数据库取样,把相关程序和反馈组织进提示,提出代码改动,交给自动评价器,再保留有价值的候选。用户提供种子程序、允许修改的范围和评价方式;系统也包含可选的元提示演化。因此,不能把它描述成“只改一段算法,其余组件永远完全不变”,但它同样不代表整个优化系统和验证器都已能自我重写。
它把部分算法发现用于支撑 AI 的计算基础设施,是 AI for AI 的重要案例。这个概念可以覆盖 AI 辅助数据生成、训练算法、系统优化和自动化研究,范围比 RSI 更宽。AI 帮人设计出更快的计算方法,已经可能有实际价值;要进一步主张递归反馈,还需追踪:改进怎样进入下一代系统,下一代是否因此更善于产生后续改进,以及收益是否抵消了发现成本。
4. 一组容易混淆、但最好分别记住的概念
| 概念 | 主要回答的问题 |
|---|---|
| Self-improvement | 系统通过自身参与的过程,是否获得了改进? |
| Recursive self-improvement | 改进结果是否进入下一轮,改进能力或机制是否也被增强?具体边界需看论文定义。 |
| Continual / lifelong learning | 跨时间学习新经验时,怎样保留旧能力? |
| Open-endedness | 怎样持续产生多样的新挑战和可利用的中间成果? |
| Co-evolution | 多个相互影响的组件怎样一起演化? |
| AGI / ASI | 我们讨论的是怎样的能力范围与水平? |
| Intelligence explosion | 改进反馈能否导致能力加速增长? |
Good 的经典讨论把机器设计更好机器与智能爆炸联系起来。但从概念上看,一段有界的自修改过程,并不足以证明未来会出现无界加速:资源、评价质量、数据覆盖和收益递减都还需要研究。
持续学习与开放式演化,为什么不能互相替代?
持续学习关注时间上的知识积累:学会新任务之后,旧任务有没有退化?新经验应该覆盖、补充还是与旧经验并存?它可以发生在一个固定的任务列表里,并不要求系统自己产生新挑战。
开放式演化更关心探索空间与新颖性:能否持续产生不同方向的挑战、保留暂时用不上的中间成果,并发生新的组合?它也可能出现大量变化,却没有在我们关心的旧任务上变好。因此,研究长期改进,往往既要测新能力,也要保留旧能力回归集;既看新颖性,也看实际用途。
共同演化则强调组件之间相互影响。任务与求解者、答案与评价者都可以共同变化,但变化也可能只是互相追逐。把评价者放进循环之后,特别需要一个相对稳定的外部尺度,才能说明系统在进步。
自修改、广泛能力与加速增长,是三个不同问题
一个系统能改写自身代码,回答的是它具有什么机制;AGI、ASI 讨论的是能力范围和水平;智能爆炸则涉及改进速度随时间如何变化。它们可能存在联系,但不能由其中一个直接推出另外两个。
例如,一个只在固定编程基准上改进的 Agent,可以是研究自修改的有效实验载体;它仍不足以说明系统具备广泛能力。即使多轮成绩提高,也要检查每轮花了多少资源、边际收益是否递减、增长是否来自更大的模型或更多尝试。本文把这些词放在同一张地图里,是为了建立联系,同时保留各自需要的证据。
5. 怎样判断“真的改进了”?
5.1 先把被改进系统与改进器分开
为了阅读方便,可以把一次更新抽象为:
其中
如果
进一步说,一个版本可能“擅长做任务”,却不擅长解释失败和提出有效修改;另一个版本当前任务分数一般,却更会探索可行方向。用前者的成绩直接替代后者的能力,容易混淆研究目标。评估改进器时,可以让它们从同一个初始系统出发,观察固定预算内后代的独立成绩、有效候选比例与失败成本。
5.2 评价信号与数据也会出问题
| 论文或基准 | 帮我们检查什么 |
|---|---|
| Large Language Models Cannot Self-Correct Reasoning Yet | 在其测试设置中,没有外部反馈的内在纠错可能失败,甚至改差;不能推广成所有模型永远无法纠错。 |
| AI models collapse when trained on recursively generated data | 不加区分地递归使用生成数据,可能损失分布信息;不能推成所有合成数据训练必然失败。 |
| AI4AI-Bench | 区分修改学习算法,与调参数或修改运行方式,研究 Agent 改进训练过程的能力。 |
| EvalResearchBench | Agent 能否设计有用、低成本的反馈与评估器,以及生成的评估器是否经得起独立检验。 |
“自己觉得更好”“开发集分数更高”“独立任务上更强”“更善于改进下一代系统”,这四种证据的含义不同。记录结果时,最好把它们分别写出来。
自我纠错的局限与模型坍塌讨论的是不同环节。前者提醒我们:没有新证据的批评可能只是把原有偏见换一种说法,也可能把正确答案改错。后者提醒我们:生成数据在反复训练中怎样改变原始分布,尤其是低概率模式,会影响长期结果。把它们都概括成“自我改进不可能”,会丢掉真正值得研究的条件。
相应地,外部反馈也不是一个自动正确的开关。执行器能检验程序是否满足已有测试,却不一定覆盖真实需求;人工标签可能存在分歧;模型评分可能受到顺序、表述或长度影响。需要检查的是反馈覆盖什么、遗漏什么,以及系统有没有机会针对评分漏洞优化。
5.3 一张实验表里,至少要拆开哪些比较?
可以把实验设计理解成逐步排除其他解释。下面的表是本文的阅读与设计建议,不是某篇论文的标准协议:
| 要回答的问题 | 建议比较 | 主要排除什么混淆? |
|---|---|---|
| 修订真的比直接回答好吗? | 相同总预算下,修订与直接生成、多次独立采样 | 收益是否只是来自多调用几次模型 |
| 跨任务经验有用吗? | 无记忆、原始历史、整理经验、打乱或不相关经验 | 改善是否来自相关经验,而非更长上下文 |
| 自动搜索比人工起点好吗? | 相同可修改范围、预算与验证条件下比较 | 搜索空间、工具条件或资源差异 |
| 元技能更新有效吗? | 固定元技能与可更新元技能,其他环节尽量一致 | 收益是否来自任务技能或分支预算变化 |
| 新改进器更强吗? | 同一初始系统,由不同改进器产生后代 | 起点更好是否被误当成改进能力更强 |
| 新评估器更可靠吗? | 在共同的独立锚点上比较排序与准确性 | 不同评委的自评分不能直接横比 |
第一,按使用方式划分数据。 候选生成可以看开发任务;版本选择会消耗验证信号;最终结论需要不参与这些选择的评估。一份数据即使叫 test 或 private,只要被反复用于挑版本,就不能仅凭名称当成完全独立的最终检验。训练、选择和最终评估的边界,应按实际信息流划分。
第二,把预算写在成绩旁边。 “同样迭代 20 次”未必公平:每轮可能调用不同数量的模型,生成不同数量的候选,还可能执行不同规模的测试。可以同时报告模型与版本、输入输出 token、候选数、工具执行时间、并发条件和总成本。搜索成本与最终部署成本也应分开记录,避免把昂贵搜索得到的轻量结果误读成整个过程都便宜。
第三,区分最佳值、平均值和变化来源。 一个纯粹的示意:10 次尝试的最高分是 80,100 次尝试的最高分是 85,不能仅凭这两个值就断言第二个改进器更强。更多采样本身就增加了找到高分候选的机会。应在预算对齐后看多次独立运行的分布,并区分“搜索找到的最佳版本”与“随机后代的平均质量”。
第四,记录失败与回退。 候选无法执行、格式无效、测试超时、得到高分但旧任务退化,这些都属于实验结果。只保留成功谱系会夸大稳定性。对长期系统,还应画旧任务回归曲线,并说明失败候选的预算是否计入总成本。
第五,评价者改变时重新校准。 如果新评委更严格,系统自评分下降也未必代表能力退化;更宽松时,分数上升也未必代表进步。保留共同评价样本、外部执行结果和评委版本,有助于把“尺子变了”与“对象变了”分开。这正是 RQGM 一类工作需要处理的核心问题。
5.4 每篇论文都可以用这六个问题做笔记
- 改进对象是什么? 答案、记忆、技能、权重、Agent 代码、改进器,还是评估器?
- 哪些部分固定? 基础模型、外层搜索、训练目标、验证器分别能不能变化?
- 反馈从哪里来? 正确答案、代码执行、环境奖励、人类标签,还是模型评价?
- 改进怎样保留? 当前上下文、跨任务记忆、文件、参数,还是一个版本档案?
- 有没有独立验证? 新任务、隐藏数据、多个随机种子和相同预算下是否仍成立?
- 测的是任务能力,还是产生改进的能力? 若主张后者,需要怎样的单独对照?
6. 从这张地图出发,可以考虑哪些研究问题?
下面是阅读后的选题思考,不是前面论文已经验证的额外结论。
路线 A:记忆与技能怎样变成可靠的长期改进?
可以连接 Reflexion、Voyager、ACE,再进入 MetaSkill-Evolve 和 Skill∞。值得测量的不是“记住多少”,而是保留哪些经验有助于后续任务,以及何时应修订、撤销或遗忘。
一个可执行的对比是:固定模型与预算,比较无记忆、原始历史、整理后的经验和可执行技能,再加入可调整的经验整理策略。分别报告当前任务、迁移任务、旧任务能力与存储和推理成本。
如果从较小实验起步,可以先选有明确执行结果的工具任务,例如代码维护或结构化信息处理。把用于积累经验的任务与用于迁移测试的任务分开,专门构造边界变化:相似表述但不同规则、旧规则失效、同一错误在不同工具中出现。这样更容易判断系统是否保留了有条件的知识,而不是记住题面。
这一方向的关键消融,是把“经验内容”和“管理经验的方法”拆开。比如先用同一批经验比较不同检索方法,再固定检索比较不同整理策略;最后才让管理策略参与更新。否则,即使完整系统更好,也很难知道是多存了有效内容,还是更会选择与修订内容。
路线 B:改进器本身是否更有效?
连接 STOP、DGM、AIDE²,比较固定改进器与可修改改进器。可以观察单位预算内产生有效候选的数量、后代质量、失败类型和跨任务迁移。
关键是设置独立测试:让不同改进器从相同初始系统出发,用相同资源做改进,再在未参与选择的任务上比较后代。这样才能减少“只是针对同一评分器越调越熟”的混淆。
可以采用一个两阶段思路:先在一组开发任务上演化改进器,得到原始版本和新版本;再冻结这两个版本,让它们分别去改进新的初始系统或处理新的任务族。第二阶段不再继续根据测试结果调整改进器,才能更清楚地研究迁移。若收益只发生在原始起点附近,结论应限定在那个范围。
相比追求“连续几十轮自动运行”的展示,更有研究价值的问题可能是:错误诊断是否减少无效修改?预算分配是否减少昂贵失败?保存非最优分支是否增加后续有效探索?这些问题可以各自设置对照,也更容易定位负结果的原因。
路线 C:评估器怎样一起进化,又不丢掉评价锚点?
连接 Self-Rewarding、RQGM 和 EvalResearchBench。可以研究低成本评估器怎样保留有效的模型排序、怎样发现评分漏洞,以及替换评估器后怎样维持历史结果的可比较性。
这条线必须有独立锚点:执行器、真实结果、人工校准或隐藏基准。否则,提高的可能是互相认可的程度,而不是任务能力。
一个较小切口是先不让评价器与任务 Agent 同时自由变化,而是收集一组质量差异明确的候选,让评价器预测排序、识别错误和估计置信度,再检查它的评价是否能帮助选择出更好的后代。评价准确率与作为搜索信号的效用有关,但并不完全相同:一个平均准确率较高的评委,也可能恰好分不清前几个高质量候选。
之后再逐步加入评价器更新,保留一部分固定校准样本,并专门测试评分漏洞。如果任务 Agent 越来越会迎合评委,应该能在独立评价中观察到偏离,而不是等到最终结果失效才发现问题。
对偏工程的工作,还可以把可追溯记录、候选版本、回滚、预算和公平复测做成研究基础设施。需要把这些机制带来的可靠性与效率收益实际测出来,而不是只展示一个能自动循环的界面。
实践中可以让每次候选更新留下一个最小记录:父版本、修改位置、提出修改的理由、使用的反馈、消耗的资源、选择结果、独立复测结果,以及是否被后代实际继承。这里不要求记录所有内部文本,而是保留足够的信息,回答“这一轮为什么发生变化,证据在哪里”。没有这层记录,长期改进很容易退化成一串无法比较的成功截图。
7. 怎么安排阅读顺序?
先建立概念地图
先读自进化 Agent 综述,了解“什么组件、何时、怎样演化”;再看 RSI 综述和 The Path to Recursive Self-Improving Agents 的框架。后两篇按当前页面信息属于预印本,框架可以帮助整理文献,不应直接当成全领域标准。
偏 Agent 系统与技能
Reflexion → ACE → STOP → DGM → MetaSkill-Evolve → AIDE²。
这条顺序从可保留的反思走到可修改的改进流程。之后接 Skill∞ 和 RQGM,分别看元技能迁移与评估者共同演化。
偏模型训练与反馈
STaR → SPIN → Self-Rewarding → Absolute Zero → 模型坍塌论文。
这条顺序把数据生成、策略训练、评价信号和退化风险放在一起。POET 可补充自动课程的历史视角,AI4AI-Bench 则把问题推进到训练算法设计。
只想先读三篇
我会选 STOP、DGM、AIDE²:分别抓住“改进器成为对象”“后代继续参与搜索”“单独检验改进能力”这三个问题。若主要关心技能系统,可把 AIDE² 换成 MetaSkill-Evolve。
每读完一个阶段,留下什么?
第一阶段不用背模型结构,给每篇论文写清“输入什么、反馈什么、留下什么变化”。读完 Self-Refine、Reflexion 与 ACE,应该能用一个自己的任务例子解释它们的差异。
第二阶段画出内外循环,在图上标记固定组件与可修改组件。读 STOP、DGM 与元技能论文时,重点找代码、技能或评价记录怎样被下一代继承,避免把所有箭头都画成一句模糊的“自我进化”。
第三阶段选一张实验图,说明横纵轴、预算、对照组、误差或随机性,以及它不能回答什么。能清楚解释 DGM Figure 2 与 AIDE² Figure 7 的证据差别,比再记住一批标题更有用。
最后再决定选题。把一个感兴趣的主张改写成可以失败的问题,例如“相同预算下,更新经验整理策略能否改善新任务表现?”并写出即使结果为负也有意义的观察项。这时,论文地图才真正转化成了自己的研究问题。
8. 论文索引:31 篇文献放回各自的位置
年份优先采用首次公开年份;已核对的正式发表信息另外列出。论文简称便于回忆,完整标题用于继续检索。
理论与直接相关方法
- Gödel Machines:Goedel Machines: Self-Referential Universal Problem Solvers Making Provably Optimal Self-Improvements。2003 起,后有多个发表版本。理论与自指。
- STOP:Self-Taught Optimizer (STOP): Recursively Self-Improving Code Generation。2023,COLM 2024。改进器自修改。
- Gödel Agent:Gödel Agent: A Self-Referential Agent Framework for Recursively Self-Improvement。2024 预印本,ACL 2025;此处采用正式 ACL 标题。运行时代码自修改。
- DGM:Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents。2025,所读 v3 标注 ICLR 2026。Agent 档案与开放式探索。
- MetaSkill-Evolve:MetaSkill-Evolve: Recursive Self-Improvement of LLM Agents via Two-Timescale Meta-Skill Evolution。2026 预印本。任务技能与元技能。
- RQGM:The Red Queen Gödel Machine: Co-Evolving Agents and Their Evaluators。2026 预印本,进行中的工作。Agent 与评估者共同演化。
- AIDE²:Recursive self-improvement of AI research agents。2026 预印本。研究 Agent 与 ignition test。
- Skill∞:Skill∞: Recursive Self-Improvement for Agent Skill Optimization。2026-10-26 预印本。可复用元技能优化。
相邻方法与组成部分
- Self-Refine:Self-Refine: Iterative Refinement with Self-Feedback。2023。推理时自我修订。
- Reflexion:Reflexion: Language Agents with Verbal Reinforcement Learning。2023。反思与文本记忆。
- STaR:STaR: Bootstrapping Reasoning With Reasoning。2022。推理自训练。
- Self-Rewarding:Self-Rewarding Language Models。2024。自我评价与偏好训练。
- SPIN:Self-Play Fine-Tuning Converts Weak Language Models to Strong Language Models。2024。迭代自博弈微调。
- Absolute Zero:Absolute Zero: Reinforced Self-play Reasoning with Zero Data。2025。出题、解题与执行反馈。
- POET:Paired Open-Ended Trailblazer (POET): Endlessly Generating Increasingly Complex and Diverse Learning Environments and Their Solutions。2019。环境与策略共同演化。
- OPRO:Large Language Models as Optimizers。2023。LLM 驱动优化。
- TextGrad:TextGrad: Automatic “Differentiation” via Text。2024。自然语言反馈优化。
- AFlow:AFlow: Automating Agentic Workflow Generation。2024。自动工作流搜索。
- Voyager:Voyager: An Open-Ended Embodied Agent with Large Language Models。2023。终身探索与技能库。
- ACE:Agentic Context Engineering: Evolving Contexts for Self-Improving Language Models。2025,ICLR 2026。上下文与经验演化。
- MAML:Model-Agnostic Meta-Learning for Fast Adaptation of Deep Networks。2017。元学习与快速适应。
- ADAS:Automated Design of Agentic Systems。2024。自动 Agent 设计。
- AlphaEvolve:AlphaEvolve: A coding agent for scientific and algorithmic discovery。2025。程序演化与算法发现。
综述与历史讨论
- 自进化 Agent 综述:A Survey of Self-Evolving Agents: What, When, How, and Where to Evolve on the Path to Artificial Super Intelligence。2025 初稿,2026 更新,页面标注 TMLR 01/2026。
- RSI 综述:Recursive Self-Improvement in AI: From Bounded Self-Refinement to Autonomous Research Loops。2026 预印本。
- The Path:The Path to Recursive Self-Improving Agents: Foundation, Framework, and Future Directions。2026 预印本,未同行评审。
- Good 的经典讨论:Speculations Concerning the First Ultraintelligent Machine。智能爆炸的历史入口;常见引用年份与当前出版社页面存在差别,此处保留原始出版链接。
评价、边界与失败分析
- 内在自我纠错的局限:Large Language Models Cannot Self-Correct Reasoning Yet。2023,ICLR 2024。
- 递归生成数据与模型坍塌:AI models collapse when trained on recursively generated data。Nature 2024;相关前身稿为 The Curse of Recursion。
- AI4AI-Bench:AI4AI-Bench: Benchmarking LLM Agents in Algorithmic Design for Recursive Self-Improvement。2026 预印本。
- EvalResearchBench:EvalResearchBench: Can AI Agents Build Their Own Feedback for Recursive Self-Improvement?。2026 预印本;采用 v2 标题。
留给下次回看的六句话
Self-Refine 看答案,Reflexion / ACE 看经验,STaR 看训练,DGM 看 Agent 后代,MetaSkill-Evolve 看改进流程,RQGM 看评估者。
RSI 文献最值得反复追问的,是改进由谁产生、怎样验证,以及这些变化有没有真正增强下一轮改进。把可修改范围与固定部分写清,再把任务能力和改进能力分开测量,才更容易把一个自动循环转化为可比较、可复现的研究问题。