微调数据里同时有摘要、问答和信息抽取时,我们通常会把它们混在一起,训练一套 LoRA。但这些任务需要的能力并不完全相同:共用少量参数,会不会让它们互相干扰?如果改成多套 LoRA,又有哪些参数其实没有必要重复保存?
HydraLoRA 就从这个问题出发。它把普通 LoRA 的一对矩阵拆成了一个共享的 A,加上多个不同的 B,再根据输入动态组合这些分支。
这篇笔记先补齐理解方法所需的 LoRA 基础,再沿着“观察 → 结构 → 实验 → 边界”阅读论文。文末留了一份速记,方便以后回忆。
先记住这三个要点
- 问题是多种数据之间的干扰与参数重复。 单套 LoRA 的适应能力有限,多套独立 LoRA 又会重复学习一部分内容。
- 方法是共享 A、分开 B、动态融合。 冻结大模型主体,训练共享矩阵、多个分支和路由器。
- 实验支持更好的参数利用效率。 应优先看同参数预算的对比,不能把它理解成“所有设置下都比普通 LoRA 更省、更快”。
| 项目 | 信息 |
|---|---|
| 论文 | HydraLoRA: An Asymmetric LoRA Architecture for Efficient Fine-Tuning |
| 作者 | Chunlin Tian、Zhan Shi、Zhijiang Guo、Li Li、Chengzhong Xu |
| 发表 | NeurIPS 2024;作者仓库标注为 Oral |
| 阅读原文 | arXiv:2404.19245 |
| 本文依据 | NeurIPS 正式论文 PDF |
| 代码 | Clin0212/HydraLoRA |
文中的截图统一来自 NeurIPS 正式版 PDF,保留原始图表编号和图注。数值是论文报告结果,本文没有复现实验;标为“推导”或“阅读思考”的部分是为理解方法补充的分析。
1. 普通 LoRA:把一次大更新分成两个小矩阵
考虑模型中的一个线性层。输入是
全量微调直接更新
这里暂时省略常见的缩放系数,避免影响对结构的理解。
| 符号 | 维度 | 作用 |
|---|---|---|
| 冻结的原始权重 | ||
| 当前线性层的输入表示 | ||
| 将输入投影到低维空间 | ||
| 将低维表示映射回输出空间 | ||
| 远小于 |
LoRA 的秩 |
把它拆成两步就容易理解了:
大模型原来的计算路径保留,旁边增加一条小分支。需要训练的矩阵参数量从
但“小”也意味着容量受限。当摘要、问答、抽取等数据都通过同一套
2. 两个观察,怎样导出一个新结构?
先看论文的结构总览:
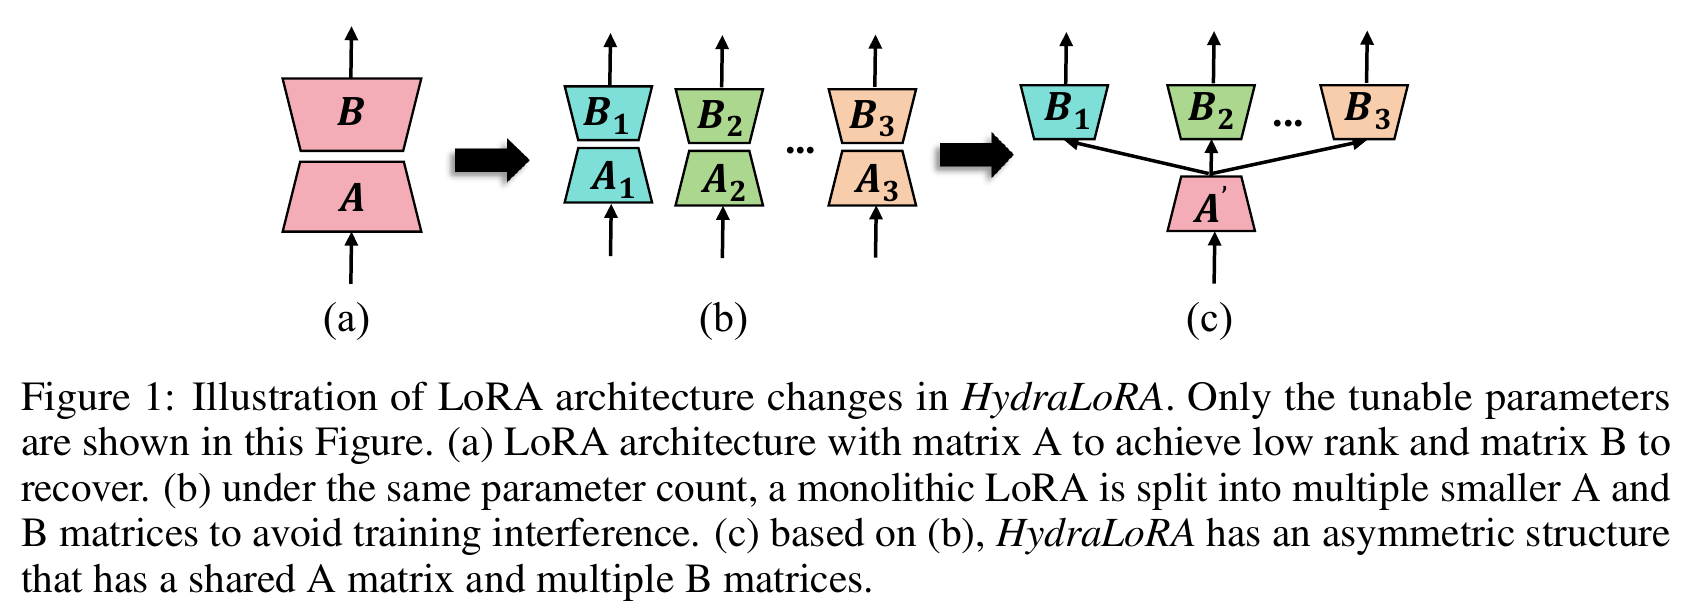
原论文 Figure 1,PDF 第 2 页。阅读顺序是左 → 中 → 右:一套 A/B → 多套 A/B → 一个共享 A、多个 B。图中展示的是可训练分支。
2.1 同样的参数预算,拆成几套小 LoRA 会怎样?
作者先比较一套较大 rank 的 LoRA,与多套较小 rank 的 LoRA。Dolly-15K 指令微调、MMLU 评估的结果如下:
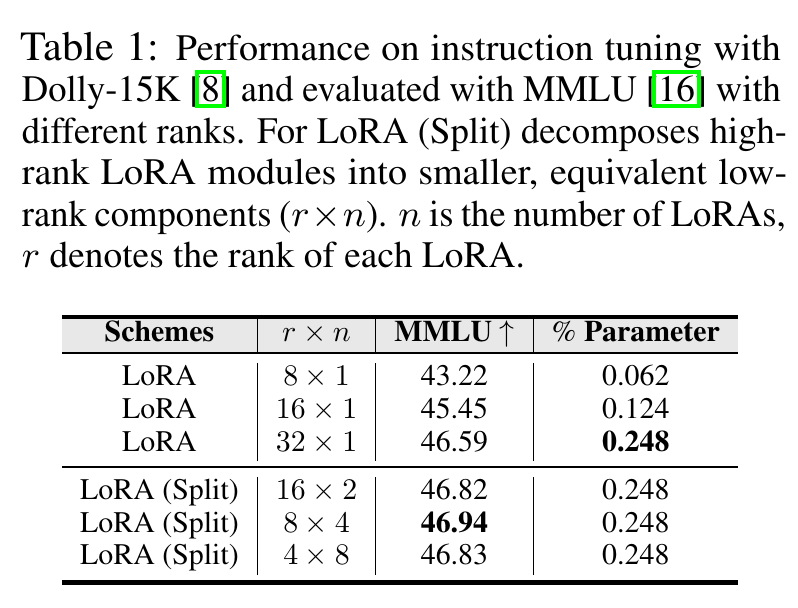
原论文 Table 1,PDF 第 3 页。
抓住其中一组对比即可:
| 配置 | 可训练参数比例 | MMLU |
|---|---|---|
| 一套 rank=32 的 LoRA | 0.248% | 46.59 |
| 四套 rank=8 的 LoRA | 0.248% | 46.94 |
参数预算相同,多套小分支略好。这给作者一个启发:参数如何组织和分工,也会影响学习效果。 不过,这组差距本身不大,不能单凭它就证明任务干扰的全部机制。
2.2 多套 LoRA 的 A、B,差异分别有多大?
接着,作者把不同数据上训练出来的 LoRA 参数做 t-SNE 可视化。
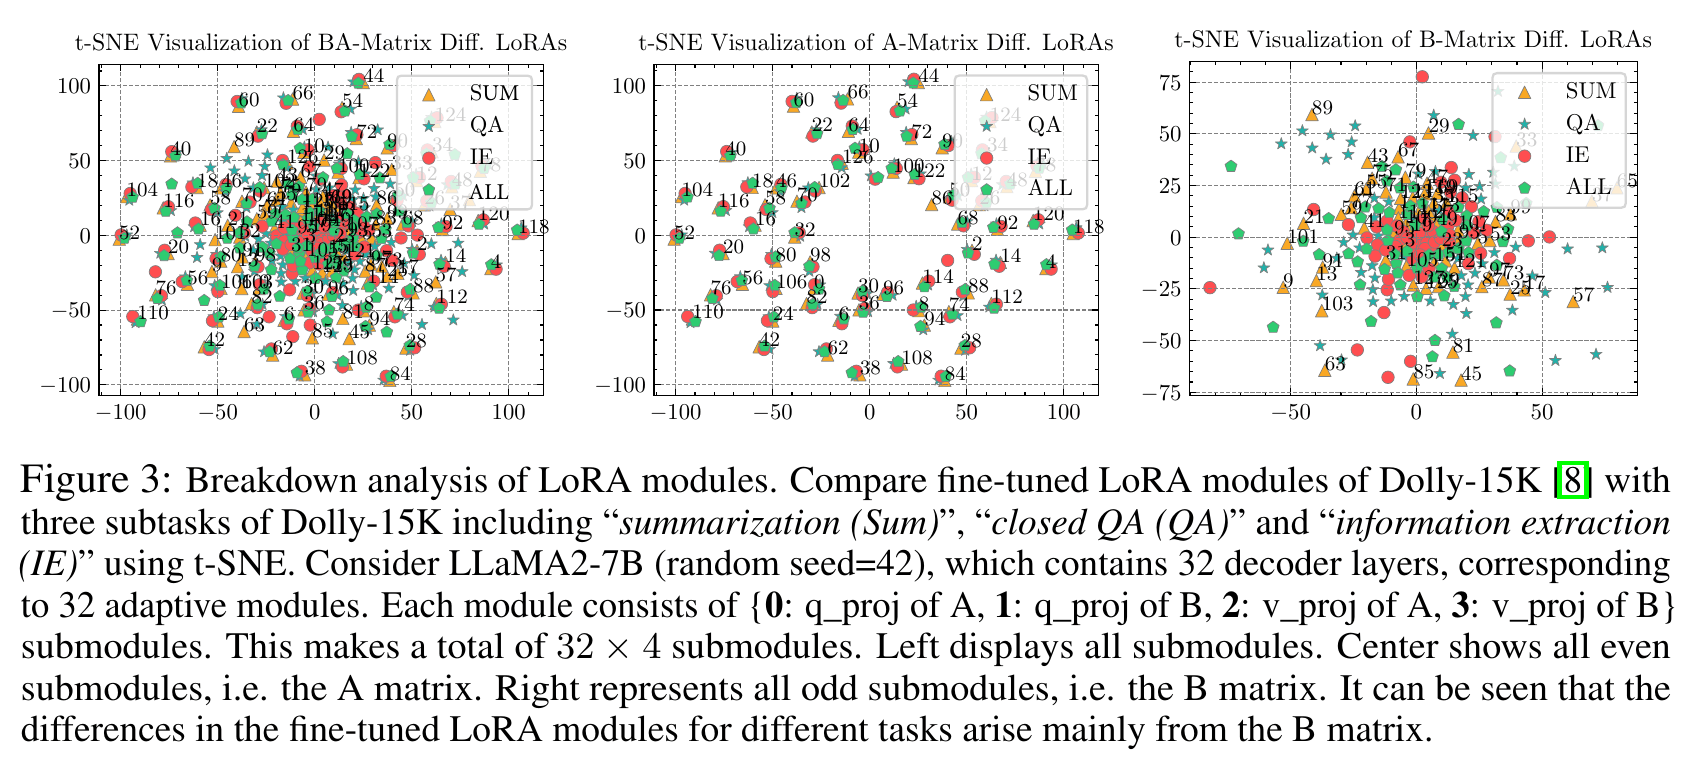
原论文 Figure 3,PDF 第 4 页。任务包括摘要、封闭问答、信息抽取,以及全部数据。中图看 A,右图看 B。
作者报告的观察是:不同任务的 A 更接近,B 的差异更明显。据此,他们提出一种分工假设:A 更适合共享,B 更适合保留各类数据的差异。
于是,结构就顺理成章了:保留多个分支,但不再为每个分支保存一份 A。
这里的“共享共性、保留差异”是一种解释结构的直觉。它不代表 A 里只能存共性,也不代表每个 B 都会自动成为一个人类可以明确命名的任务专家。
3. HydraLoRA:先共同投影,再分别处理
HydraLoRA 的核心公式是:
相比普通 LoRA,它增加了多个
从数据流看,可以分成三步:
- 共同投影:
,所有分支使用同一份低维表示。 - 分别变换: 各分支计算
。 - 按需融合: 路由器输出权重,把分支结果加权组合起来。
为避免原文中输入表示符号的复用,这里把路由网络统一写作
这表达的是路由器的功能,不规定实现时一定从哪一个张量取输入。
例如,为了理解公式,可以假设三个分支对某个输入的权重是
这组权重只是说明性例子。真正的权重需要训练得到,也不要求只选中一个专家。
专家数量从哪里来?
论文提供了基于 TF-IDF、K-means 和肘部法估计数量的办法,也允许开发者指定
因此,“不依赖人工领域标签”不等于“完全没有需要设置的超参数”,也不意味着聚类后就能得到一组永久固定、语义明确的专家标签。
4. 参数到底省在哪里?自己算一遍
下面是根据矩阵形状得到的推导,只统计 A/B 参数,暂不计路由器、偏置等开销。
| 结构 | A/B 参数量 |
|---|---|
| 一套普通 LoRA | |
| HydraLoRA |
相对
假设输入、输出维度相等,即
这时相对三套独立 LoRA,约省下三分之一的 A/B 参数。但它仍然比同 rank 的单套 LoRA 参数更多。
也可以代入一个具体例子:当
| 配置 | 参数个数 |
|---|---|
| 单套 LoRA,rank=8 | 65,536 |
| 三套独立 LoRA,每套 rank=8 | 196,608 |
| HydraLoRA,rank=8、三个 B | 131,072 |
| 单套 LoRA,rank=16 | 131,072 |
这就是为什么实验中应重点比较 HydraLoRA rank=8 与普通 LoRA rank=16:它们的 A/B 参数预算相当。 如果只拿两个 rank=8 的方法比较,就混入了参数量增加的影响。
5. 训练与推理分别发生了什么?
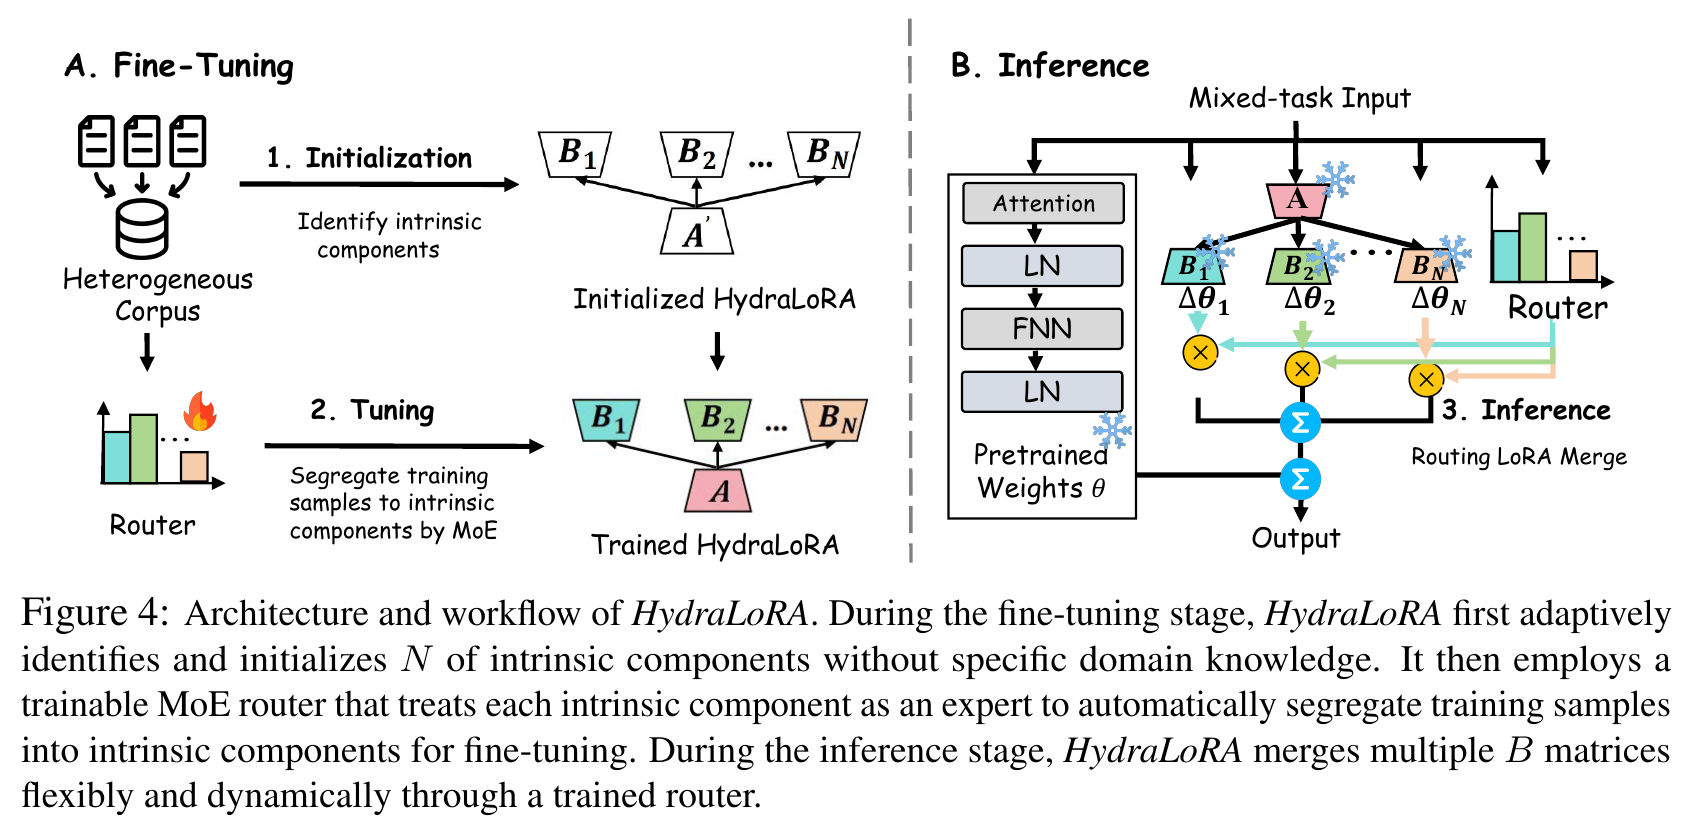
原论文 Figure 4,PDF 第 5 页。左边看哪些模块参与训练,右边看输入如何经过路由和加权融合。
训练时冻结大模型主体,更新共享 A、多个 B 和路由器。训练数据仍然用来优化任务目标;路由器学习不同分支怎样参与当前输入的计算。
推理时参数停止更新,但路由器仍根据输入计算融合权重。由于各个 B 都是线性变换,公式可以整理成:
对当前输入定义:
于是增量就写成
但需要区分两件事:可以在代数上合并当前输入对应的 B,与可以提前得到一份对所有输入通用的固定权重,是两回事。 只要
6. 实验支持了哪些结论?
6.1 单领域微调:相同参数量,效果如何?
论文覆盖通用指令、医疗、法律、数学和代码,分别采用对应训练数据,再在 MMLU 或其领域子集、GSM8K、HumanEval 等基准上评估。这些列来自不同领域的微调实验,并非同一个模型混合训练后的一次统一评测。 GSM8K 使用 8-shot,其余列按原表采用 zero-shot 设置。
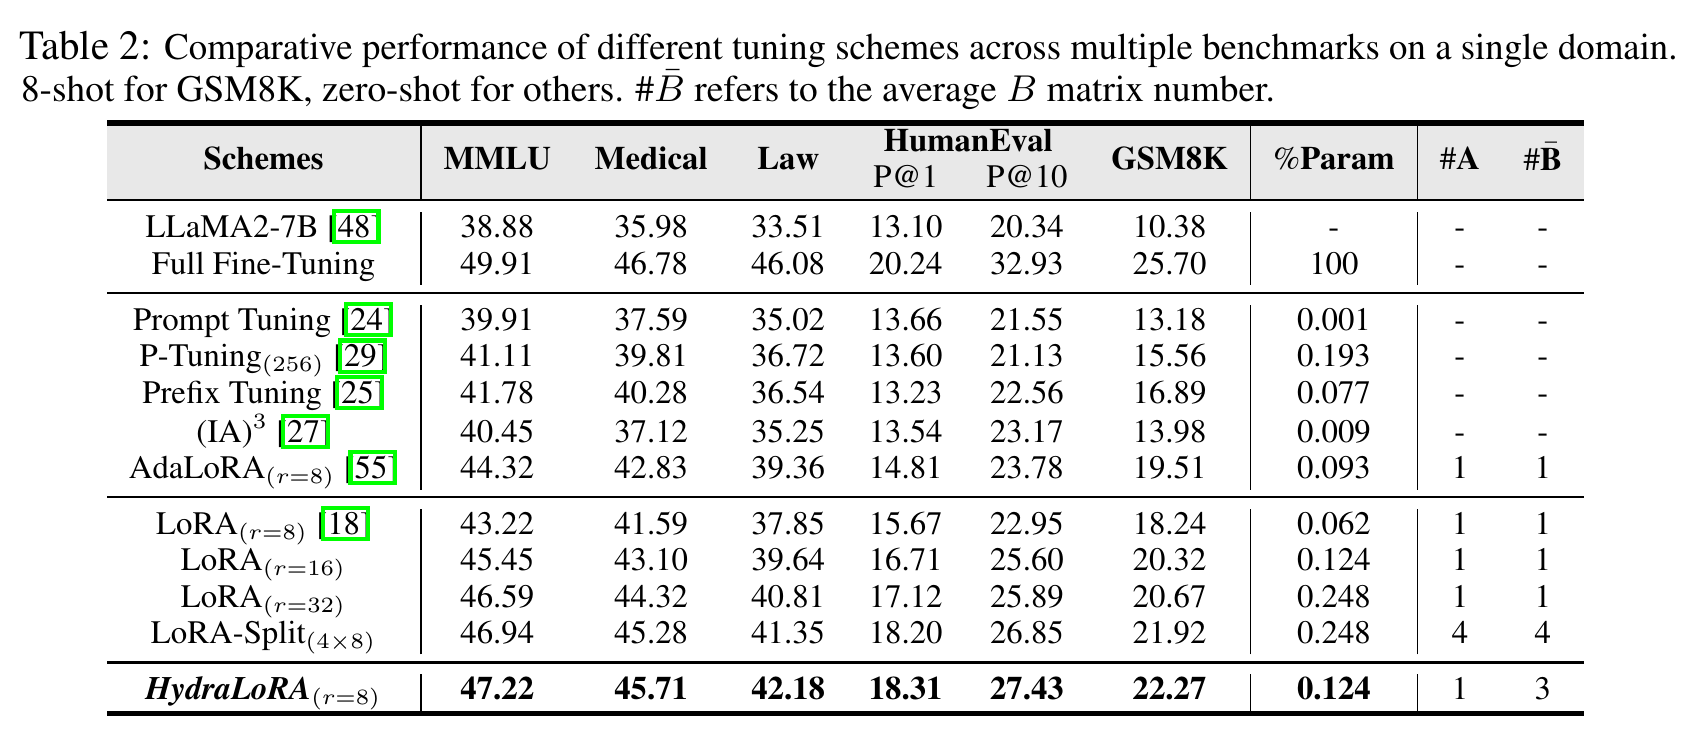
原论文 Table 2,PDF 第 6 页。%Param 为论文报告的可训练参数比例,最后两列给出 A/B 模块数量;B 数量为平均值。
为方便比较,从原表摘出几行:
| 方法 | 参数比例 | MMLU | GSM8K | HumanEval P@1 |
|---|---|---|---|---|
| LoRA,rank=8 | 0.062% | 43.22 | 18.24 | 15.67 |
| LoRA,rank=16 | 0.124% | 45.45 | 20.32 | 16.71 |
| LoRA,rank=32 | 0.248% | 46.59 | 20.67 | 17.12 |
| HydraLoRA,rank=8 | 0.124% | 47.22 | 22.27 | 18.31 |
| 全量微调 | 100% | 49.91 | 25.70 | 20.24 |
这里有三层信息:
- 与同参数比例的 LoRA rank=16 相比,HydraLoRA 的 MMLU 高 1.77 个百分点,GSM8K 高 1.95 个百分点。
- 与参数量更多的 LoRA rank=32 相比,它仍然更好,说明收益不只是“多放一些参数”。
- 全量微调依然更好。这里体现的是参数预算与效果之间更好的折中,不能写成全面超过全量微调。
6.2 混合任务:比多套独立 LoRA 更划算吗?
在混合任务设置中,论文使用部分 Flanv2 数据训练,在 BBH 上做 3-shot 评估:
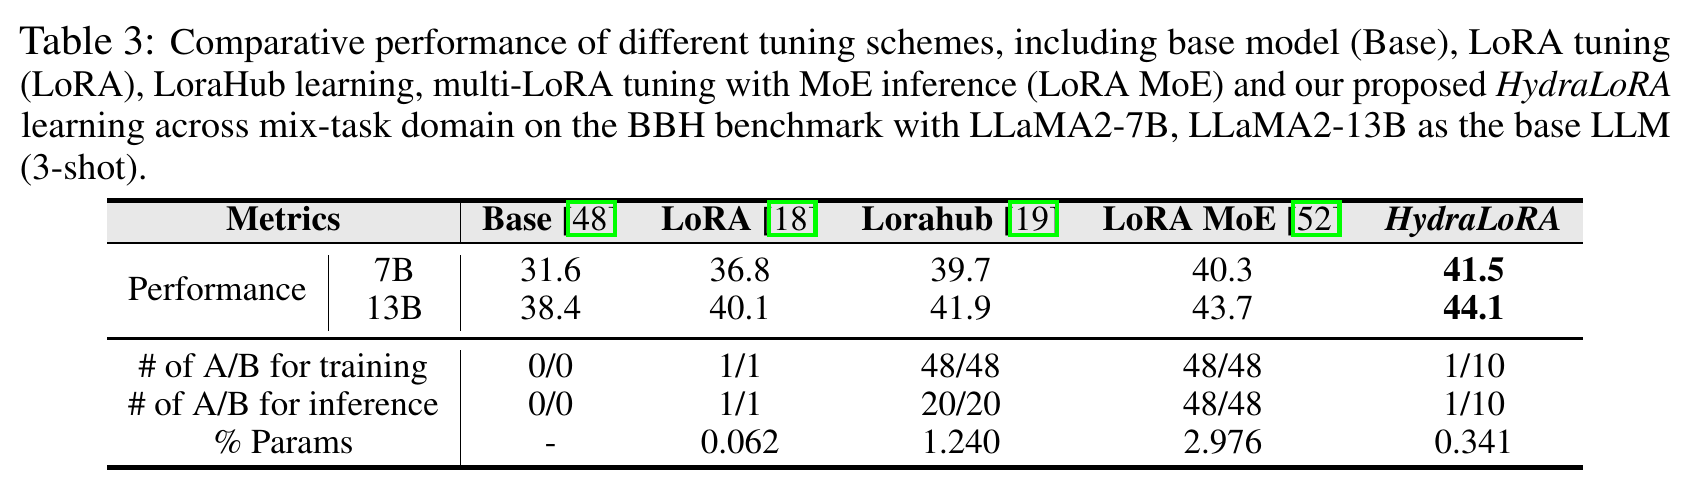
原论文 Table 3,PDF 第 7 页。注意同时看得分、参数比例和 A/B 数量。
在 LLaMA2-7B 上,LoRA MoE 为 40.3,HydraLoRA 为 41.5;表中对应参数比例分别为 2.976% 与 0.341%。这个结果支持:在论文采用的配置下,非对称结构可以用更少参数取得更高的平均分。
不过,这两者的专家数量也不相同:表中 LoRA MoE 使用 48 套 A/B,HydraLoRA 使用一个 A、十个 B。它是完整方案的比较,不能把全部收益都归结为“只共享了 A”这一个变量。
另外,普通 LoRA 在该表的参数比例只有 0.062%。因此,HydraLoRA 相对普通 LoRA 的 36.8 → 41.5,也不属于同参数预算对比。
6.3 消融:路由器和非对称结构分别有没有帮助?
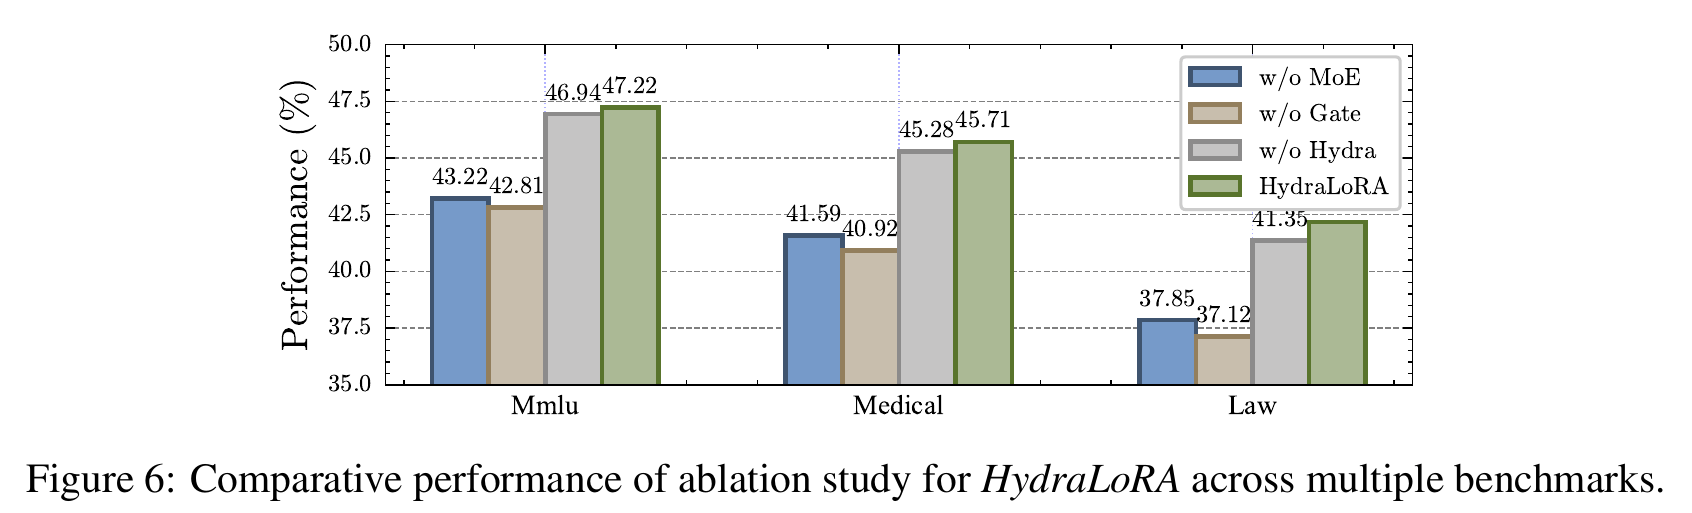
原论文 Figure 6,PDF 第 8 页。完整方法在图中的三个领域均取得最高分。
按论文定义:
| 变体 | 改动 |
|---|---|
| w/o MoE | 移除专家结构,基本退回普通 LoRA |
| w/o Gate | 不学习融合权重,使用均匀权重 |
| w/o Hydra | 使用多套普通 LoRA,去掉共享 A 的设计 |
这张图说明,简单地“放多个分支再平均”不够,融合方式也很重要。同时,完整结构相对 w/o Hydra 的收益较小,例如 MMLU 是 46.94 → 47.22;缺少多随机种子方差时,不宜对这种小差距作过强解释。
7. 效率实验:记住比较对象和测量范围
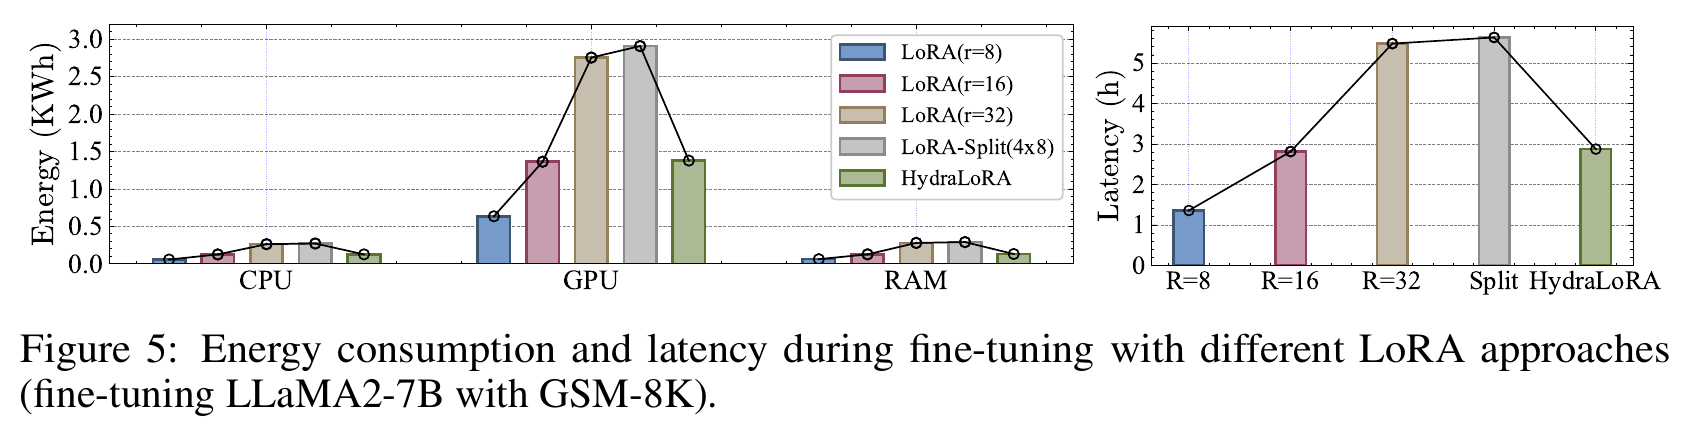
原论文 Figure 5,PDF 第 8 页。左图是 CPU、GPU、RAM 的能耗,右图是训练耗时;右图单位为小时。
论文使用 LLaMA2-7B 在 GSM8K 上微调,硬件为 4 张 NVIDIA A40,能耗由 CodeCarbon 记录。作者报告,相对 LoRA rank=32,HydraLoRA 训练提速约 1.96 倍,能耗降低 **49.6%**。论文 §4.3
正确回忆这个结果时,要把三个条件一起带上:
- 测的是这一组配置下的微调训练,并不是在线推理的首 token 延迟或输出吞吐。
- 比较对象是 rank=32 的 LoRA。图中 rank=8 的普通 LoRA 耗时更短,不能概括成 HydraLoRA 总是最快。
- HydraLoRA 与 rank=32 LoRA 的参数预算不同。这支持一种更好的效果与成本折中,但不是严格同预算下的纯算子加速实验。
所以,读到“高效”时最好继续追问:省的是参数、训练时间、能耗,还是推理延迟?这些指标相关,但不能互相替代。
8. 阅读思考:这个设计有什么边界?
8.1 参数可视化可以启发设计,但不是机制证明
下面是额外的数学思考。
LoRA 的分解并不唯一。对于任意可逆矩阵
换了一组 A/B 坐标,整体更新仍然相同。因此,直接比较原始 A、B 的距离,会受到初始化、优化过程和坐标选择影响。t-SNE 又是降维可视化,不能仅凭图上的重合就证明“A 在所有任务中承担相同语义”。
我会把 Figure 3 看成结构设计的线索,再结合任务结果和消融判断这个结构是否有用。若要更扎实地分析机制,可以继续比较
8.2 多个 B,不等于自动变成高秩更新
对某个固定输入,把路由权重视为已知量,有:
所以:
这说明不能简单说“有
动态路由让不同输入使用不同组合,整个适配映射可以具有更丰富的输入依赖行为;但这与把一个固定线性更新直接提升到
8.3 共享有收益,也可能限制差异
所有分支都从
正式版附录 D 也指出,任务的语言、类型、领域等异质性,以及污染或对抗性数据,可能削弱共享知识与聚合的效果;论文没有验证预训练阶段的有效性。论文附录 D
因此,面对一份新数据,比较合理的做法是先建立普通 LoRA 基线,再判断增加分支是否值得。论文结果也不能直接替代在其他模型、其他数据上的测量。
9. 如果以后复现,我会怎样安排对比?
这一节是实验设计建议,不是论文已经完成的额外实验。
第一步固定底座、数据划分和训练 token 数,比较三种结构:单套 LoRA、多套独立 LoRA、共享 A 的 HydraLoRA。需要同时报告实际训练参数量,不能只列 rank。
第二步控制参数预算,观察相同预算下,分支数量和每个分支 rank 的取舍。把“多专家增加容量”和“共享 A 改变结构”的影响尽量分开。
第三步把效果和成本一起记录:任务得分、多个随机种子的波动、训练时间、峰值显存,以及真实推理吞吐与延迟。若路由能画出分布,再观察专家是否长期被平均使用,或大部分输入都集中到少数分支。
最后再分析共享是否合理:例如把 A 固定、换成独立 A,或者只在部分层共享。这样才能进一步回答“为什么有效”,而不只是“跑出来的分数更高”。
10. 留给下次阅读的速记
| 想回忆的问题 | 记住什么 |
|---|---|
| 它解决什么? | 异构数据下,单套 LoRA 的干扰与多套 LoRA 的重复参数 |
| 核心结构是什么? | 一个共享 A、多个不同 B、输入相关的融合权重 |
| 从哪里得到启发? | 同预算拆分 LoRA 的实验,以及 A/B 参数差异的可视化 |
| 核心公式是什么? | |
| 参数省在哪里? | 相对多套独立 LoRA,少存了 |
| 最有说服力的比较? | 表 2 中 HydraLoRA rank=8 与 LoRA rank=16 的同参数比例对比 |
| 什么不能直接推出? | 所有任务都更好、全面超过全量微调、推理零开销、更新秩变成 |
| 我最想带走的启发? | 设计微调结构时,先考虑哪些部分值得共享,哪些差异需要保留 |
原文与延伸入口
- HydraLoRA:NeurIPS 正式发表页面。
- HydraLoRA:正式版 PDF。图表、实验数值及章节编号均以此为准。
- HydraLoRA:arXiv 页面。保留最初阅读入口;不同版本的附录组织和部分讨论有差异。
- HydraLoRA:作者代码仓库。尤其可以看 README 中关于 MoE 与 K-means 的说明。
- LoRA: Low-Rank Adaptation of Large Language Models。需要补基础时,从原始 LoRA 论文开始。